CLAUDE.md に決まりを書き足すうちに、長くなって守られなくなった。
そんな経験はありませんか? 私の CLAUDE.md も、一時は345行まで膨らんでいました。
AI に何を読ませるかを、まとめて設計する考え方があります。 それがコンテキストエンジニアリングです。
コンテキストエンジニアリングは、AI が読む情報全体を、必要な時に必要な分だけ渡す設計です。プロンプトは、その一部にすぎません。
全部を先に置かず、CLAUDE.md は短い道しるべにして、詳しいことは使う時・触った時に読ませる。普段は AI の判断に任せ、大事な所だけ決まりと仕組みで止めるのが、私のやり方です。
目次
コンテキストエンジニアリングとは?AIが読む情報全体の設計

プロンプトの書き方とは、何が違うんですか?

プロンプトは、AI に送る1回分の文です。コンテキストは、AI がその時に読んでいる情報の全部です。
AI が読むのはプロンプトだけではない
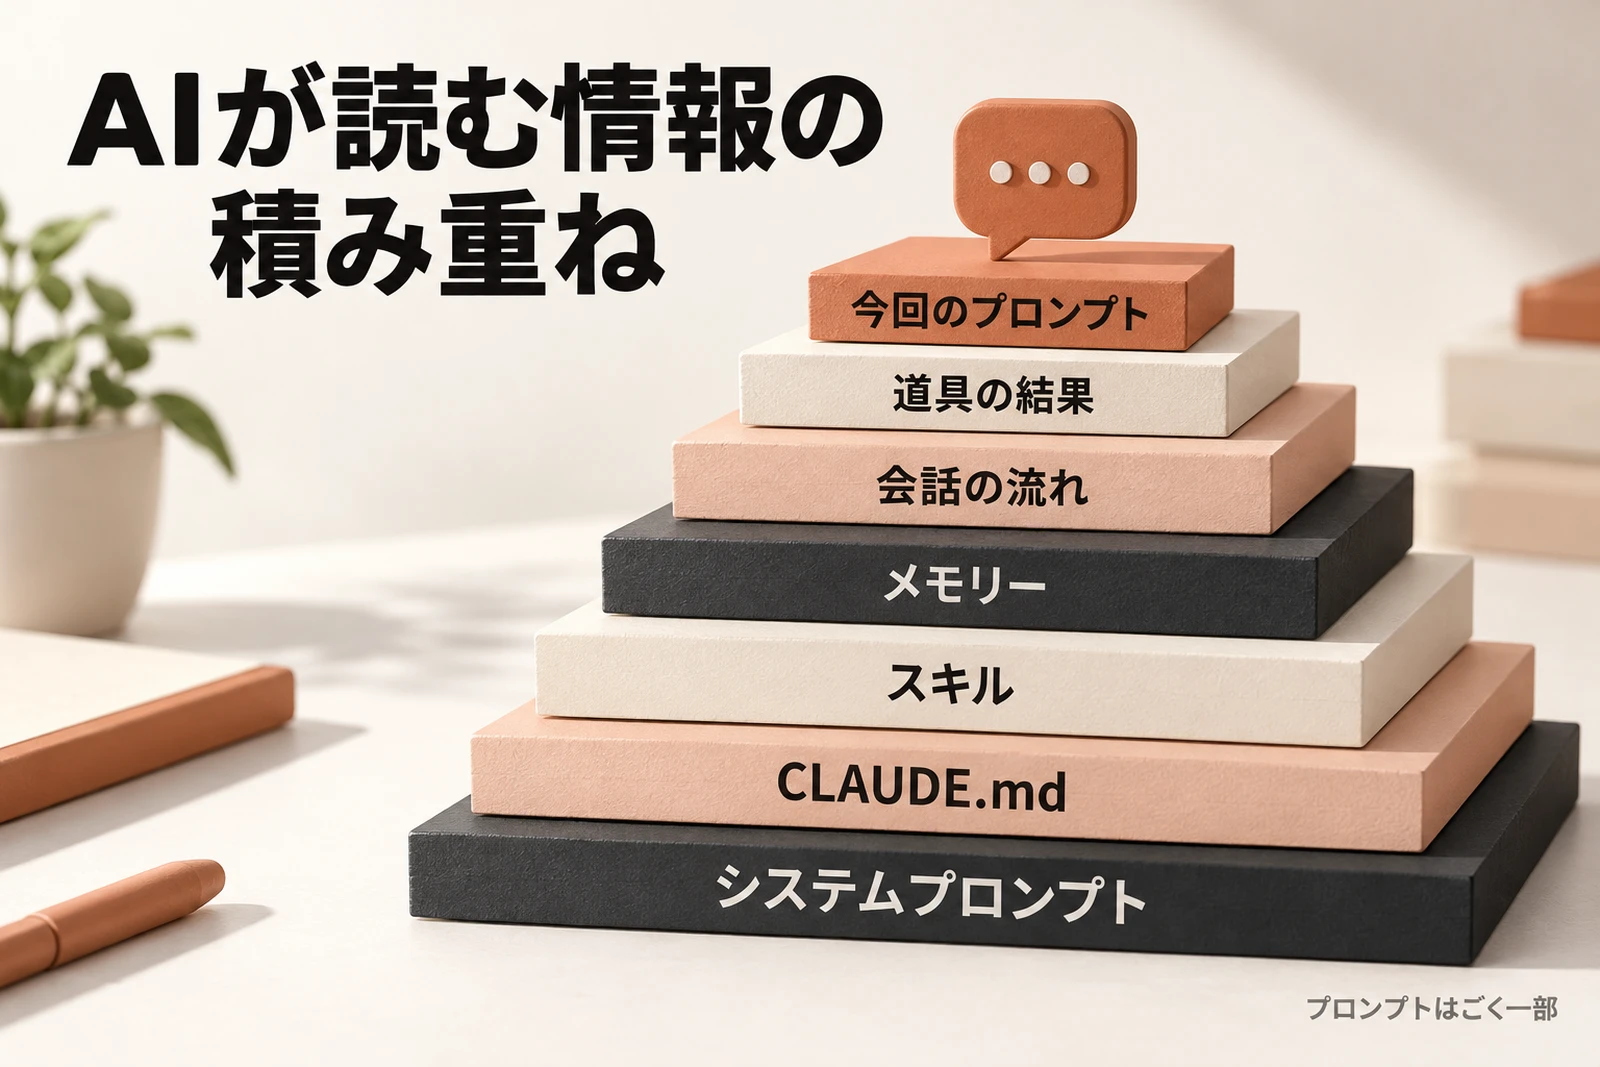
Claude の公式ブログは、こう説明しています。 Claude にメッセージを送るとき、プロンプトは、AI が受け取る情報のごく一部です。
ほとんどは、システムプロンプト(道具に最初から入っている指示)・スキル・CLAUDE.md・メモリーなどから組み立てられます。 この全体を設計することを、コンテキストエンジニアリングと呼んでいます。
プロンプトエンジニアリングとの違い
プロンプトエンジニアリングは、1回の指示の書き方と並べ方の工夫です。 コンテキストエンジニアリングは、その指示も含めて、何を・いつ・どれだけ読ませるかを決めることです。
Anthropic は、コンテキストエンジニアリングを「プロンプトエンジニアリングの自然な発展」と呼んでいます(2025年9月)。
 プロンプトエンジニアリングとは?書き方より知識を入れる時代へ
細かいプロンプトの作り込みは大きく減った
Claude Code のチームは、2026年7月の公式ブログで、驚く数字を出しました。 Claude Opus 5 や Claude Fable 5 のような新しいモデル向けに、Claude Code のシステムプロンプトを80%以上削っても、コーディングの評価で測れる性能の低下は無かったそうです。
細かいルールや例をたくさん書き込む作り方は、新しいモデルでは必要が大きく減っています。
プロンプトエンジニアリングは、もう必要なくなったと私は感じています。プロンプトを自分で打つほど、知識や、指示を伝える国語力が必要になり、難しくなるからです。
AI で作るものは、AI に作らせるのが合理的で正しいと考えています。そのほうが性能も担保されると感じています。ただ、前の記事で書いた「最初の目的を伝える」ことは、今も自分でしています。
なぜ必要?情報は多いほど良いわけではない
「それなら、知っていることを全部 AI に渡せばいい」と思うかもしれません。 でも、情報は多いほど良いわけではありません。
長くなるほど、答えの確かさが落ちる
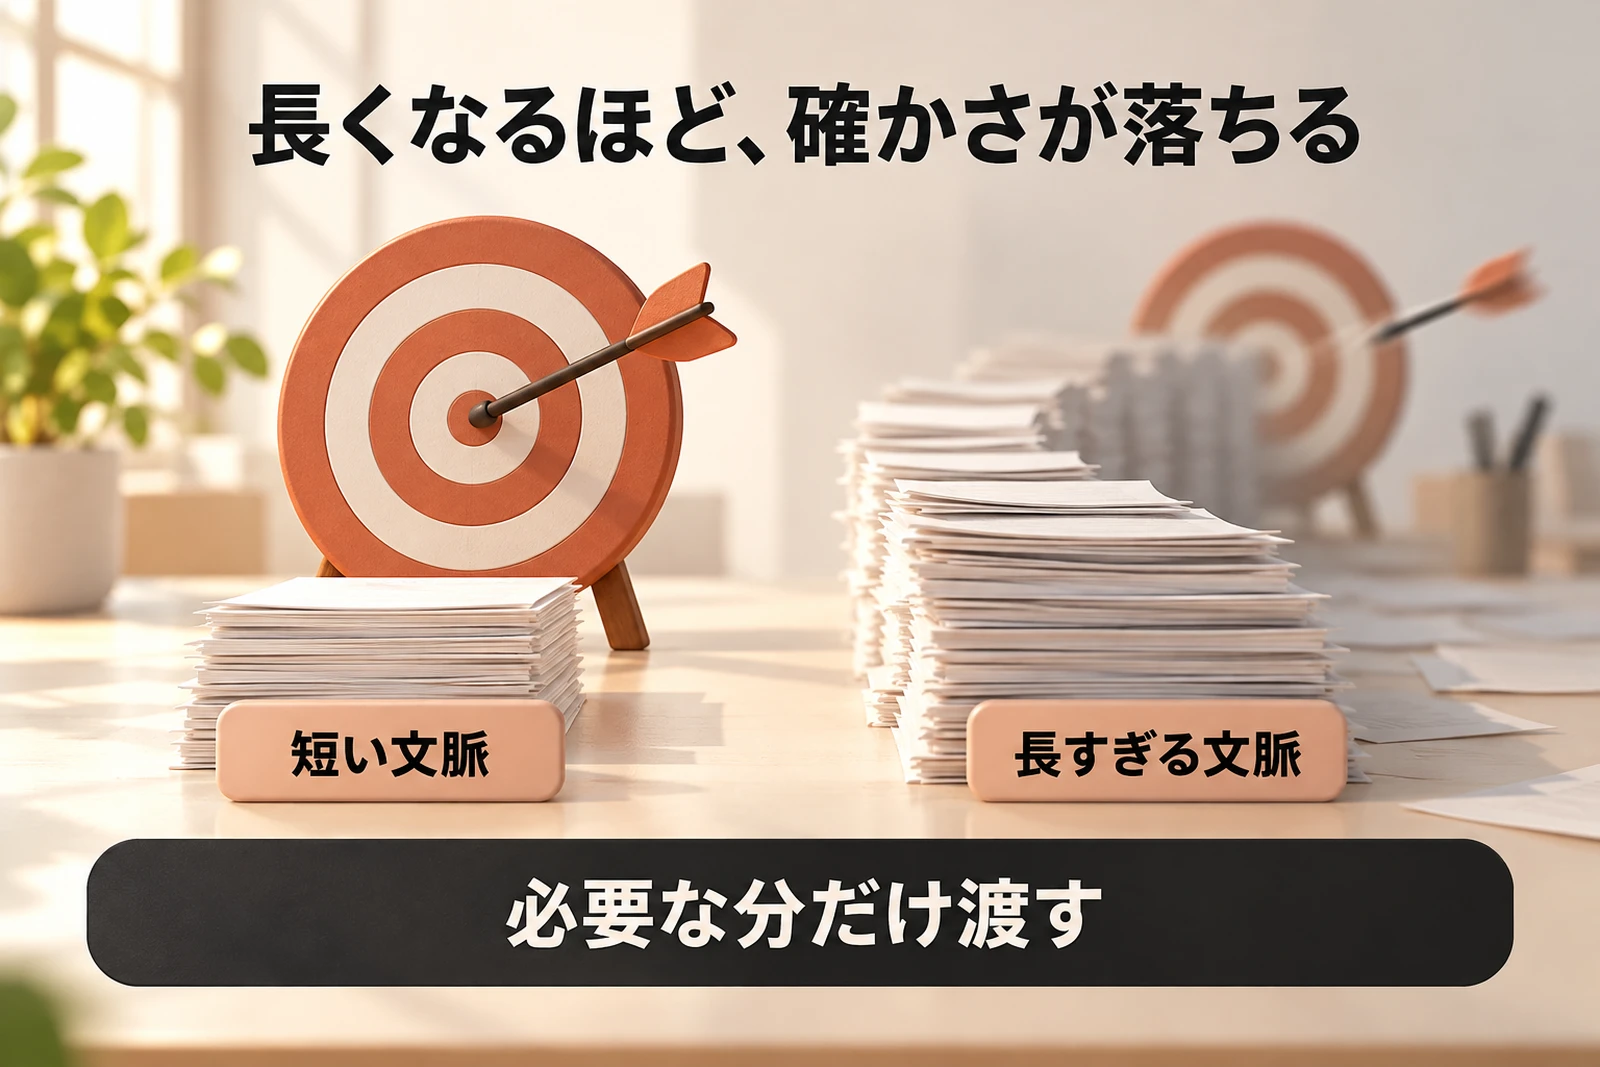
AI 向けの検索の仕組みを作る Chroma は2025年7月、18のモデルで、入力の長さと性能の関係を調べました。 簡単な課題でも、入力が長くなると性能が大きく変わり、確かさが落ちていくことが分かりました。
この現象は「context rot(文脈の劣化)」と呼ばれます。 Anthropic も、情報が増えるほど、AI がそこから正しく思い出す力が落ちると書いています。
縛りすぎると、指示どうしがぶつかる
Claude Code のチームは、自分たちの使い方の記録を読み返しました。 すると、1つの頼み事の中で「必要に応じてドキュメントを残して」と「コメントを書くな」が同時に入っていたそうです。
システムプロンプト・スキル・頼み方の指示が、ぶつかり合っていたのです。 AI は意図を読み取れますが、そのぶん余計に考えることになります。
決まりを書き足すほど、別の決まりとぶつかりやすくなります。「念のため」の決まりを増やす前に、本当に毎回要るかを考えてください。
公式が示した「昔と今」
Claude の公式ブログは、これまでの常識のうち6つが「もう古い」と書いています。
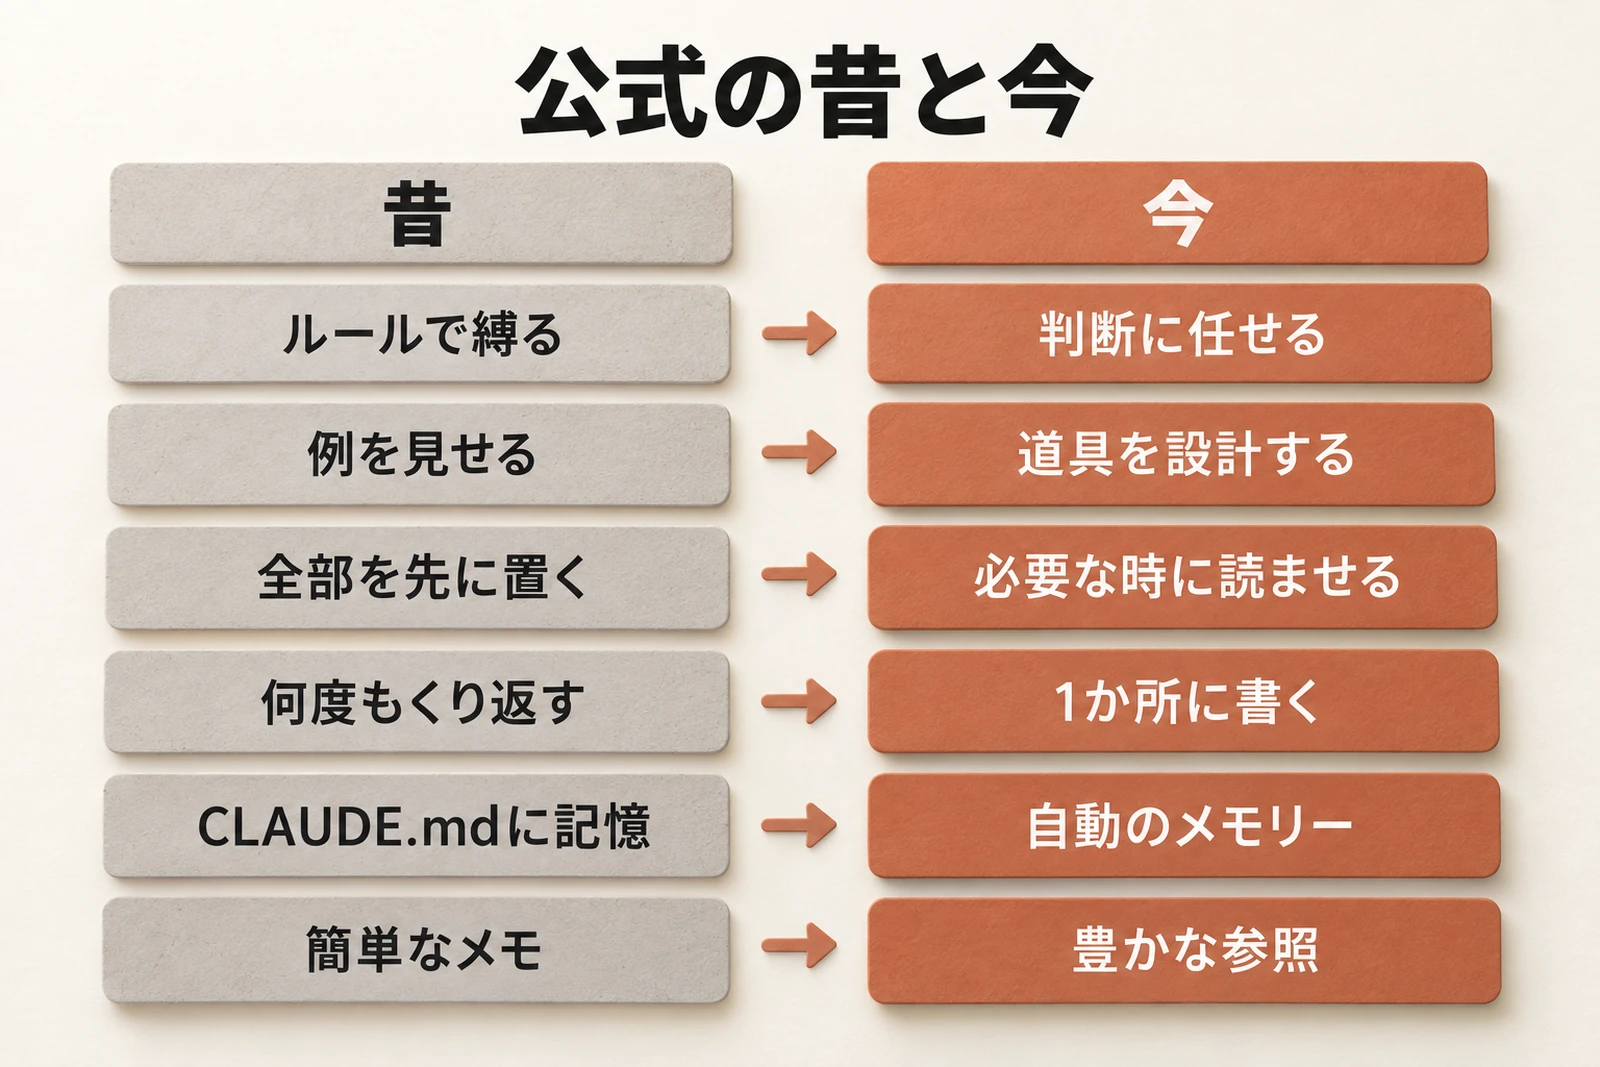
縛るより、判断に任せる
以前の Claude Code は、「コメントは基本書かない。書いても短い1行まで」のような強い決まりを持っていました。 今のシステムプロンプトでは、その部分が「周りのコードと同じように読めるコードを書く(コメントの量・名前の付け方・書き癖を合わせる)」という1文になっています。
禁止を並べる代わりに、目指す状態を1つ示す形です。
全部を先に置かず、必要な時に読ませる
公式が例を挙げてくわしく書いているのが、段階的な開示です。 必要な情報を、必要な時に読み込ませる考え方です。
Claude Code では、確かめ方やレビューの手順を、本体から外して別のスキルに分けたそうです。 スキルは、説明文だけが一覧として常に読まれ、本文は使う時だけ読み込まれます。
CLAUDE.md は短く、落とし穴を書く
公式は、CLAUDE.md を軽くして、リポジトリの「落とし穴」に字数を使うよう勧めています。 ファイルを見れば分かることは書かない、とも書いています。
Claude Code の公式ドキュメントも、CLAUDE.md は1ファイル200行未満を目安にしています。
私の Vault のコンテキスト設計
私は Obsidian の Vault を、Claude Code と Codex の作業場にしています。 全部を CLAUDE.md に書かず、必要な時に読ませる形に作り替えてきました。
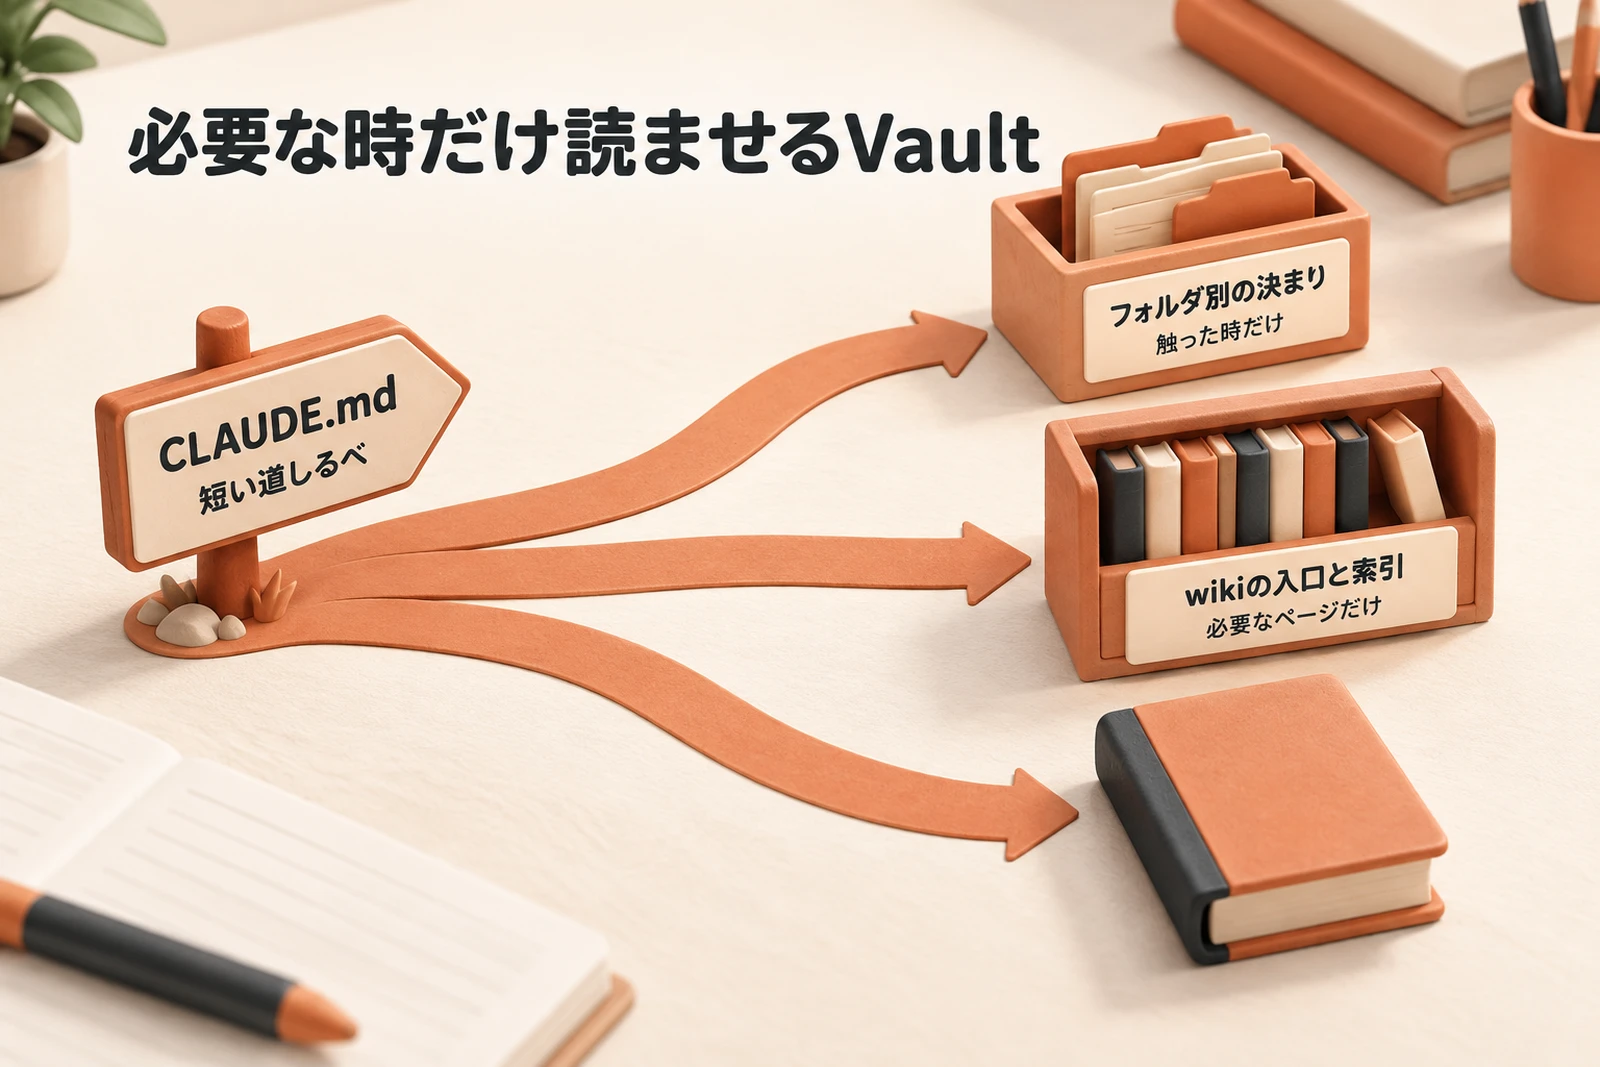
CLAUDE.md は道しるべだけ
私の CLAUDE.md は162行です。 冒頭に「詳細は正本へ切り出し、ここには骨子だけを置く」と書いています。
決まりの中身は別のファイル(正本)にあり、CLAUDE.md にはどこを読めばいいかだけを置いています。 以前は345行あったのを、169行まで縮めたのが始まりでした。
フォルダ別の決まりは、触った時だけ読ませる
一部のフォルダでしか使わない決まりは、.claude/rules/ という場所に5つのファイルで分けました。
それぞれのファイルに、どのフォルダを触った時に読ませるかを書いてあります。
たとえば、この Lab の記事の決まりは、記事のフォルダを触った時だけ読まれます。 記事を書かない作業では、記事の決まりが文脈を使いません。
 Claude rulesとは|CLAUDE.mdとの違いと読まれる時
wiki は入口と索引で、必要なページだけ開く
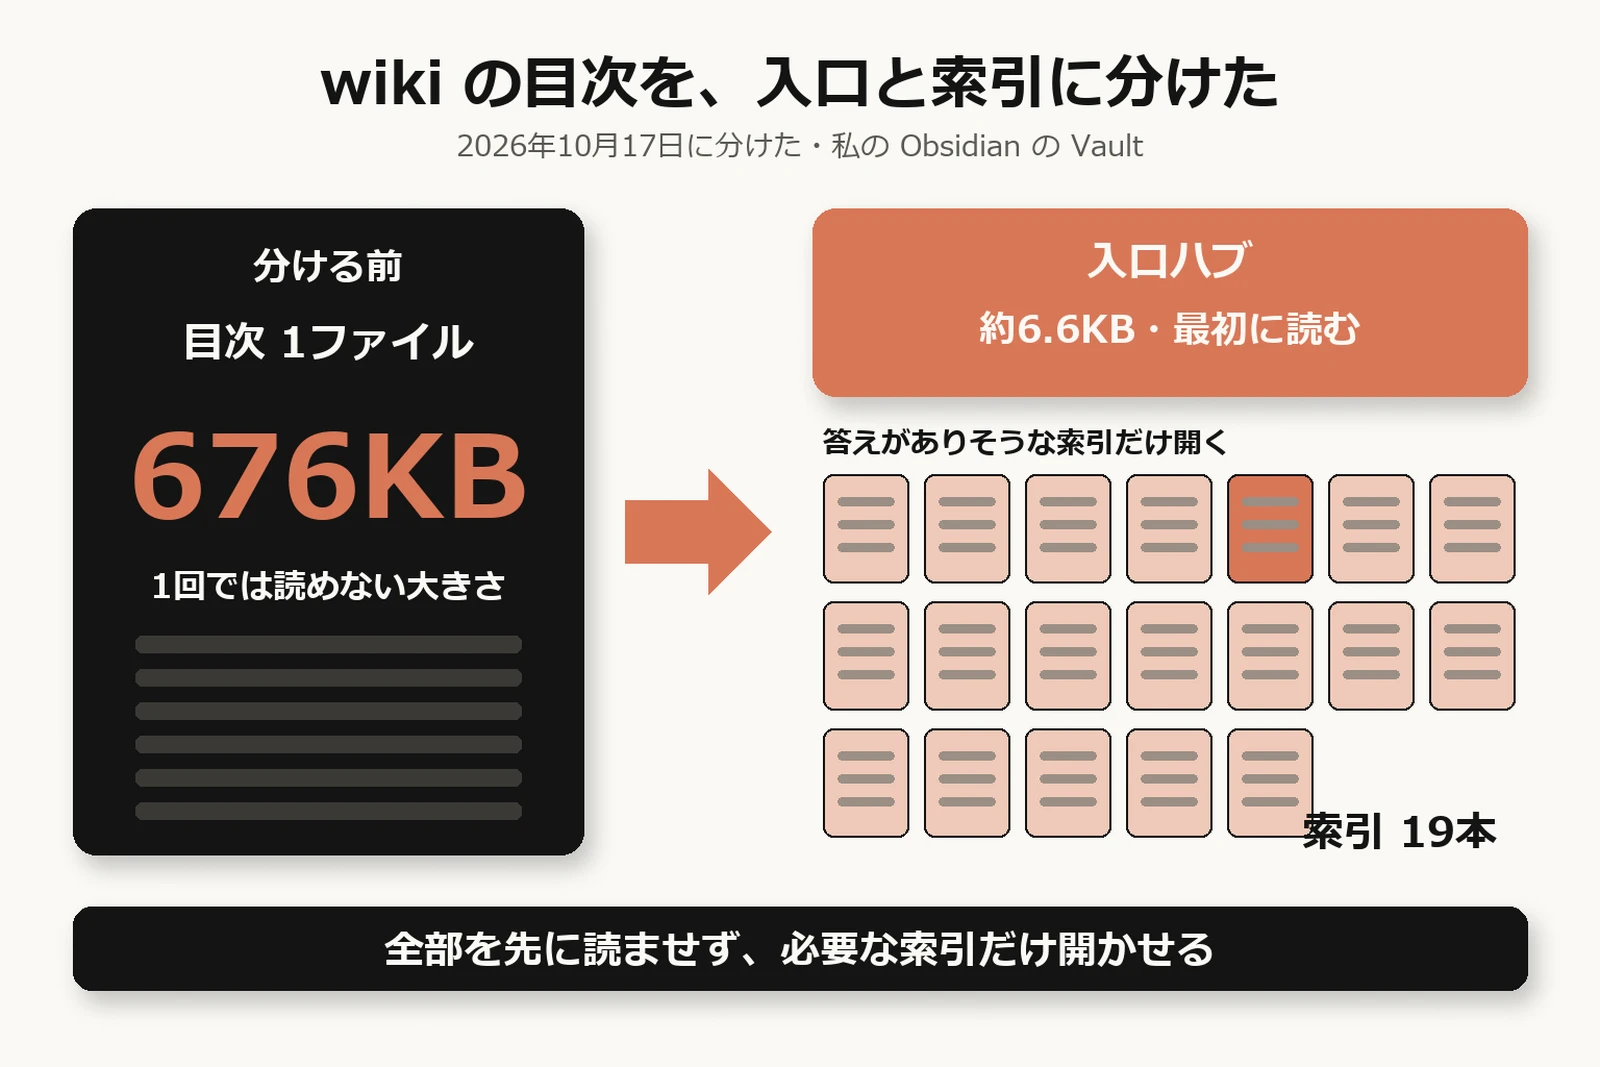
wiki の目次は、ページが増えて676KBになり、1回では読めない大きさになっていました。 そこで2026年10月17日に、小さな入口ハブと、フォルダごとの19本の索引ファイルに分けました。
AI はまず入口ハブを読み、答えがありそうな索引だけを開いて、必要なページにたどり着きます。
大事な所だけ縛る
私は、公式の「判断に任せる」と、「縛る」の両方を使っています。 普段の作業は任せていますが、守らないと困る所だけは、決まりと仕組みで止めています。
たとえば、記事やブログの本番への公開は、私が自分で行う決まりです。 集めた元の資料(raw)は、AI が書き換えない決まりにしています。
普段は AI の判断に任せ、公開や削除のように取り返しのつかない所だけを縛る。両方を使い分けるのが、今のところいちばん楽で安全だと感じています。
自分の環境で始める3ステップ
最初から全部を作り替える必要はありません。 いちばん長いファイルを1つ選んで、短くするところからで十分です。
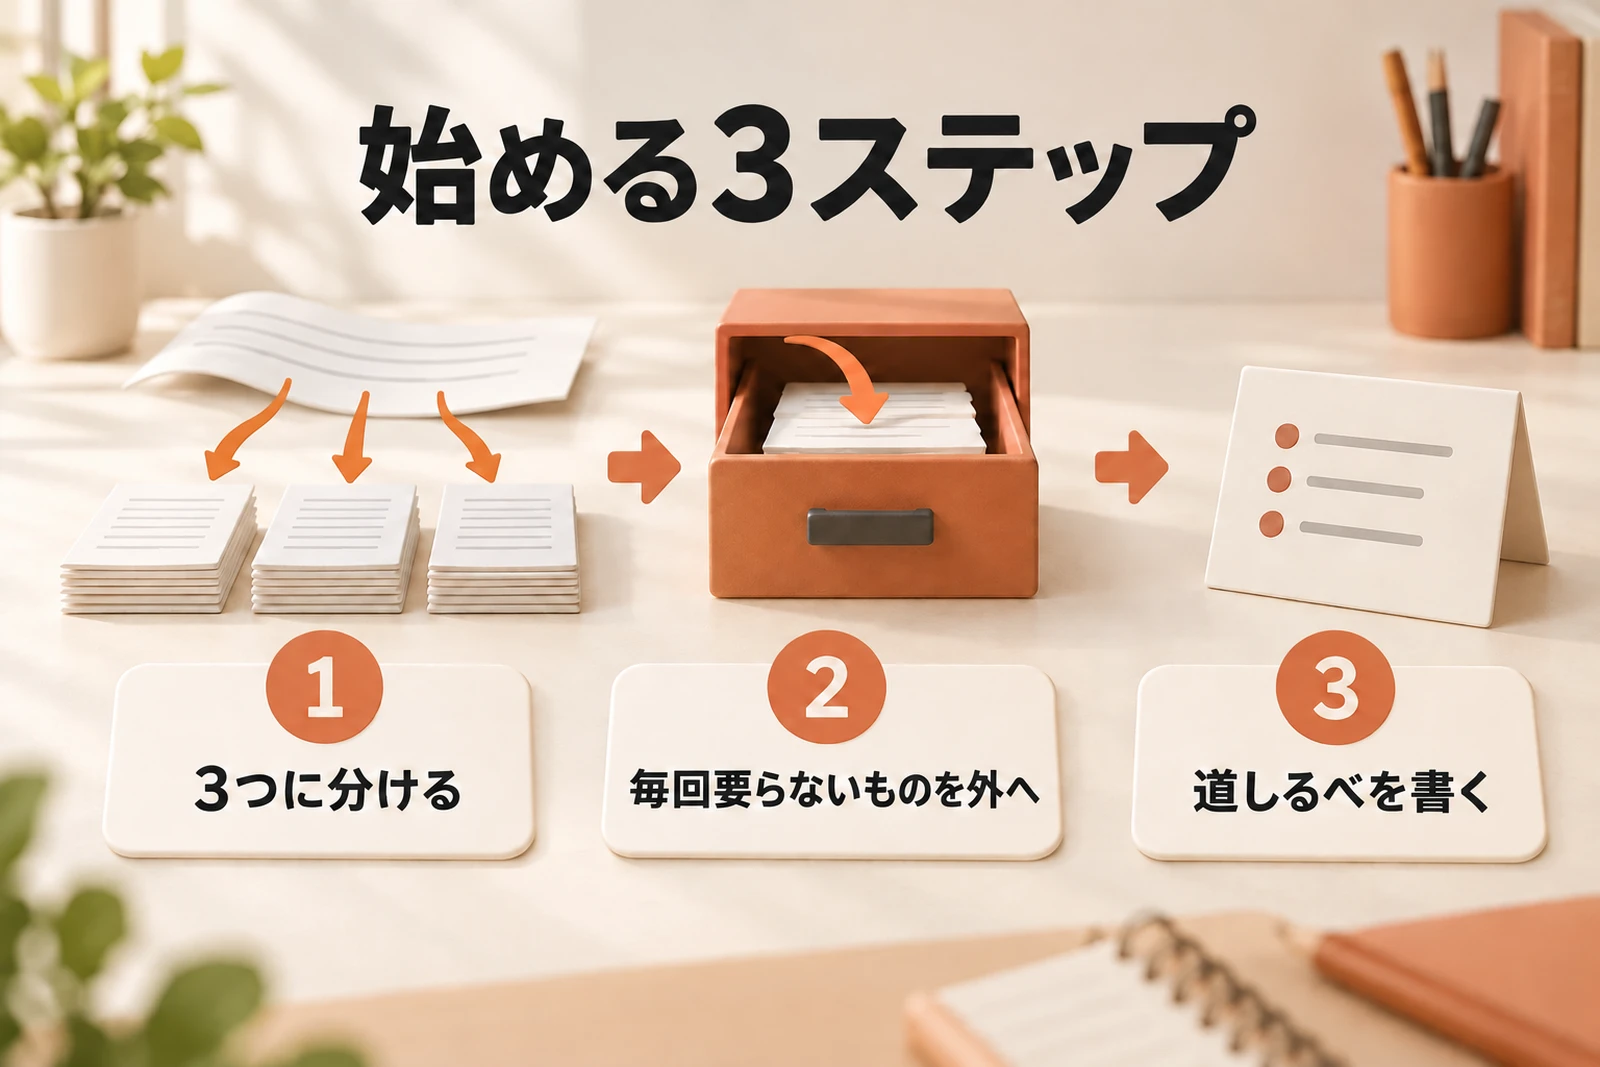
- CLAUDE.md の中身を3つに分ける
毎回要る決まり・一部の作業だけの決まり・見れば分かること、に分けます。
- 毎回要らないものを外に出す
一部の作業だけの決まりはスキルやフォルダ別の決まりへ、見れば分かることは消します。
- 道しるべを書く
CLAUDE.md には「詳しくはこのファイル」とだけ書き、必要な時に読ませます。
1と2は、AI に頼んで一緒に進められます。
この CLAUDE.md を、
①毎回の作業で必要な決まり
②一部のフォルダや作業でだけ必要な決まり
③ファイルを見れば分かること
の3つに分けて一覧にしてください。まだ書き換えないでください。
分けたあとに、どこへ移すかを一緒に決めると、消しすぎを防げます。
長い作業の途中で会話が重くなったら、サブエージェントに分けるのも1つの手です。
 Claude Codeサブエージェントの使い方|頼み方と作り方
よくある質問
プロンプトエンジニアリングとの違いは何ですか?
プロンプトエンジニアリングは、1回の指示の書き方の工夫です。 コンテキストエンジニアリングは、指示も含めて、AI が読む情報全体を、いつ・どれだけ渡すかの設計です。
プロンプトエンジニアリングは不要になりましたか?
細かい言い回しを作り込む必要は、大きく減りました。 公式も、新しいモデル向けに自社のシステムプロンプトを8割削っても、コーディングの評価で性能が落ちなかったと書いています。私自身は、もう必要なくなったと感じています。ただ、何をしてほしいかという最初の目的は、今も自分で伝えています。
CLAUDE.md には何を書けばいいですか?
毎回の作業で必要な決まりと、落とし穴だけです。 一部の作業だけの決まりは、スキルやフォルダ別の決まりに分け、CLAUDE.md には道しるべを書きます。
ハーネスエンジニアリングとの違いは何ですか?
ハーネスは、AI を作業させるための、モデルの外側の仕組み全体(道具・権限・手順など)のことです。 コンテキストエンジニアリングは、その中の「何を読ませるか」を担う部分だと考えると分かりやすいです。
まとめ
- コンテキストエンジニアリングは、AI が読む情報全体を、必要な時に必要な分だけ渡す設計
- 情報は多いほど良いわけではなく、長いほど確かさが落ち、決まりどうしもぶつかる
- 公式は、新しいモデル向けに Claude Code のシステムプロンプトを8割削っても、コーディングの評価で性能が落ちなかった
- CLAUDE.md は短い道しるべにし、詳しいことは使う時・触った時に読ませる
- 普段は判断に任せ、公開や削除など大事な所だけ縛る
まずは、いちばん長いファイルを1つ選んで、3つに分けるところから始めてみてください。
参考資料・出典
公式(2026年10月18日確認)
- Claude「The new rules of context engineering for Claude 5 generation models」:https://claude.com/blog/the-new-rules-of-context-engineering-for-claude-5-generation-models
- Anthropic「Effective context engineering for AI agents」:https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Claude Code「Extend Claude with skills」:https://code.claude.com/docs/en/skills
- Claude Code「How Claude remembers your project」:https://code.claude.com/docs/en/memory
研究・第三者(2026年10月18日確認)
- Chroma「Context Rot: How Increasing Input Tokens Impacts LLM Performance」:https://www.trychroma.com/research/context-rot
- LangChain「Context Engineering」:https://www.langchain.com/blog/context-engineering-for-agents
- Manus「AIエージェントのためのコンテキストエンジニアリング:Manus構築から得た教訓」:https://manus.im/ja/blog/Context-Engineering-for-AI-Agents-Lessons-from-Building-Manus
- Google 広告 キーワードプランナー(日本・2025年10月〜2026年9月)