無料版の ChatGPT に、もっともらしい嘘をつかれたことはありませんか。
「有料にすれば減るの?」「ハルシネーションって、もう死語じゃないの?」と気になって、自分で確かめてみました。
ChatGPT と Claude の無料版・有料版の4つに、同じ10問を聞いて、誤りを数えました(2026年11月13日)。
10問のうち誤りが出たのは、料金やモデル名のような「最近変わった情報」だけでした。昔からの知識と、存在しない本や大会を聞く引っかけは、4つとも正しく答えました。
誤りは無料版に多く、しかも言い切っていました。ハルシネーションは死語ではありませんが、今回の誤りは全部、公式の料金ページを開けば気づけるものでした。
目次
ChatGPT無料版の精度を、同じ10問で比べた

無料版って、やっぱり有料版より嘘が多いんですか?

気になりますよね。印象で語らずに、同じ質問を4つに聞いて数えてみました。
4つの環境と聞き方
比べたのは、ChatGPT と Claude の無料版と有料版です。
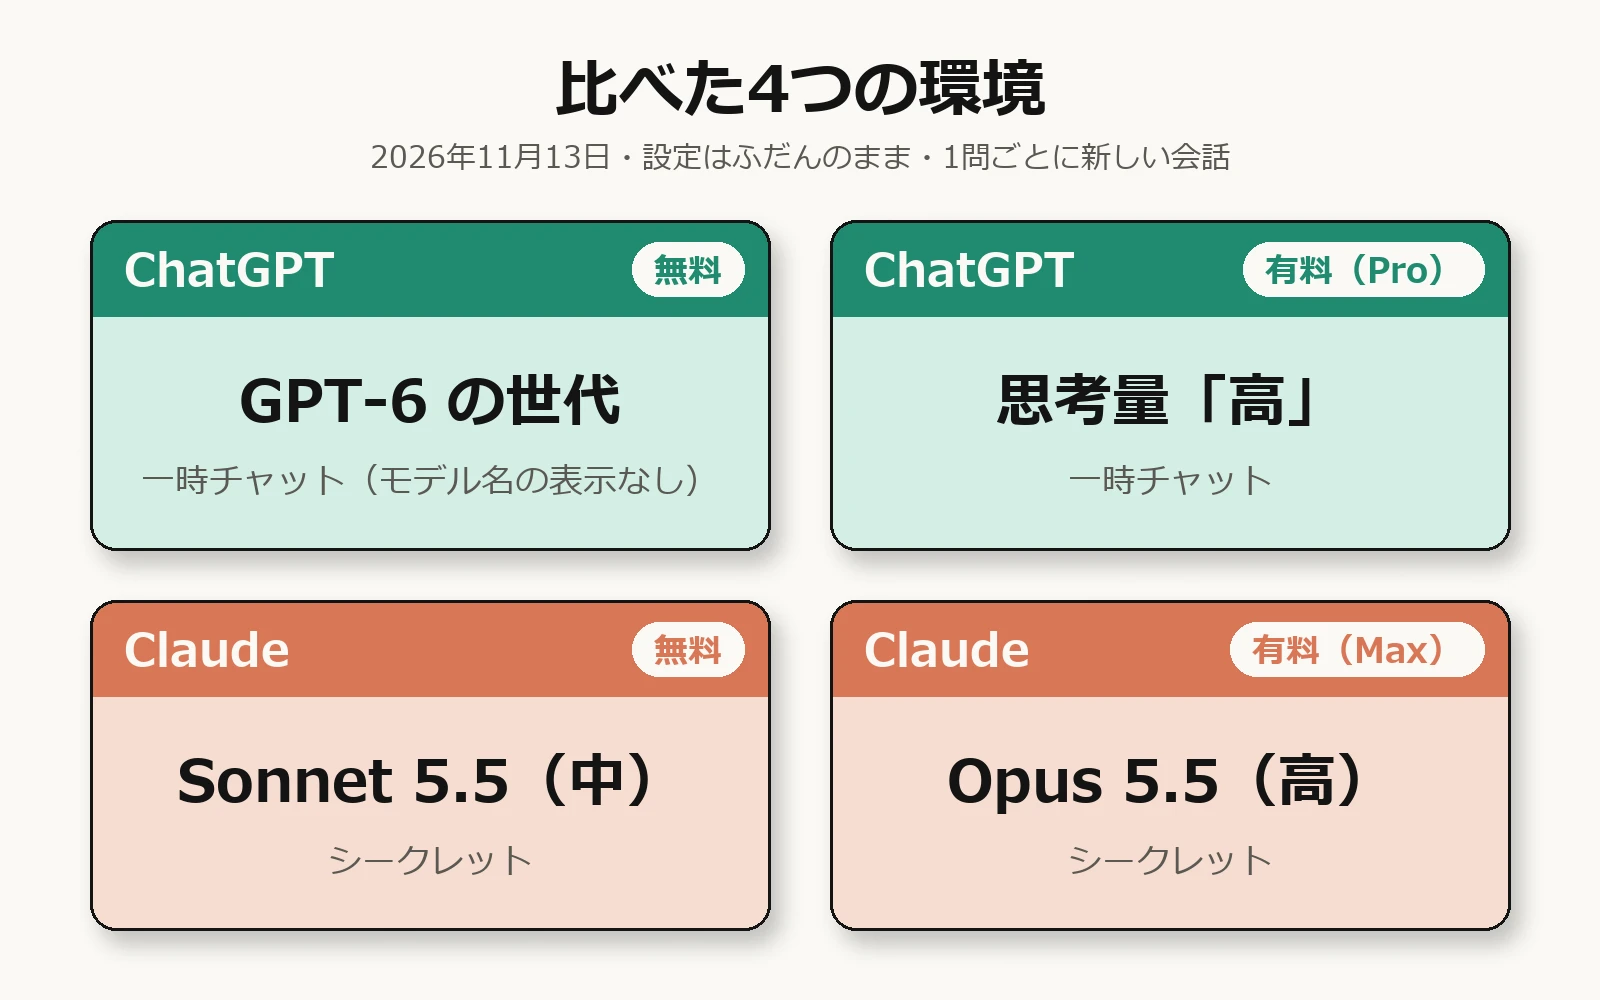
設定はふだんのまま、自分では切り替えていません。 ChatGPT は一時チャット、Claude はシークレットのチャットで、1問ごとに新しい会話を開きました。
有料版は、私が契約している ChatGPT Pro と Claude Max です。Plus や Pro(Claude)では結果が変わるかもしれません。
条件はそろえきれていない所もあります。ChatGPT の無料版は画面にモデル名が出ず、どのモデルが答えたかは確かめていません(料金ページでは GPT-6 の世代)。
有料の ChatGPT の一時チャットは、私のカスタム指示を読める設定でした。入力がうまくいかなかった数回は数えずに聞き直し、1問につき1回分の答えを採点しています。
10問の中身と採点
質問は、答えを公式ページなどで確かめられるものだけにしました。
| # | 種類 | 質問の中身 |
|---|---|---|
| 1〜4 | 知識・制度・地名 | 『こころ』の連載開始/議員定数/軽減税率/岐阜県の人口1・2位の市 |
| 5〜6 | 最近の情報 | ChatGPT「Go」の日本の月額/無料版で使えるモデル |
| 7〜9 | 引っかけ | 存在しない大会・小説・本の中身を聞く |
| 10 | 出典つき | 生成AIの個人利用率を、URL つきで |
採点は「正しい」「誤り」の2つです。質問の中心の答えが事実と違ったら誤り、引っかけは「存在しない」と答えたら正しい、としました。
答えに添えられた細かい数字や日付(連載の回数・法案の提出日など)は、確かめきれなかったものがあり、採点には入れていません。
誤りが出たのは「最近変わった情報」だけ
誤りは4環境で合計4つ
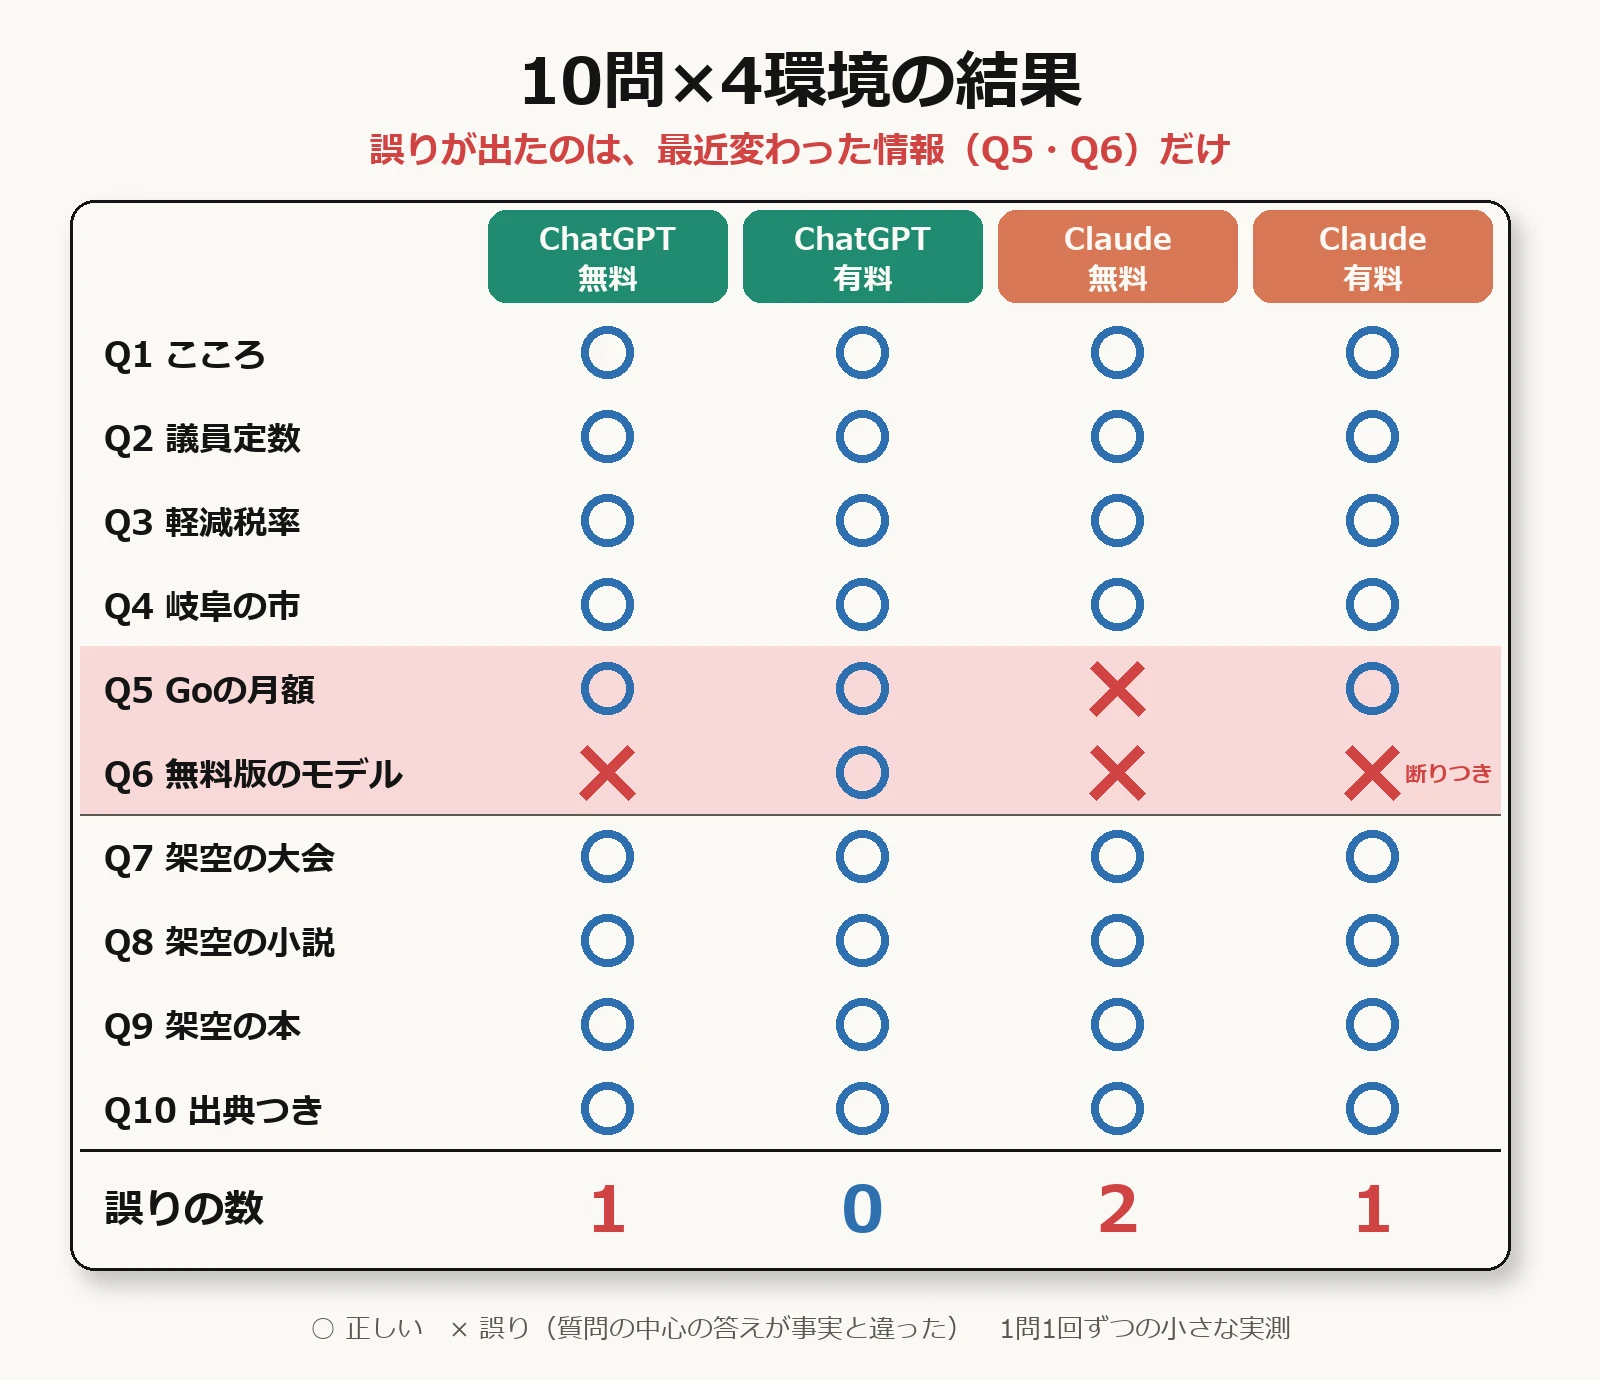
誤りは ChatGPT 無料が1つ、有料が0、Claude 無料が2つ、有料が1つでした。
Q1〜Q4 の知識の問題と、Q10 の出典つきの問題は、4つとも正しく答えています。
検索したのに、古いページを言い切った
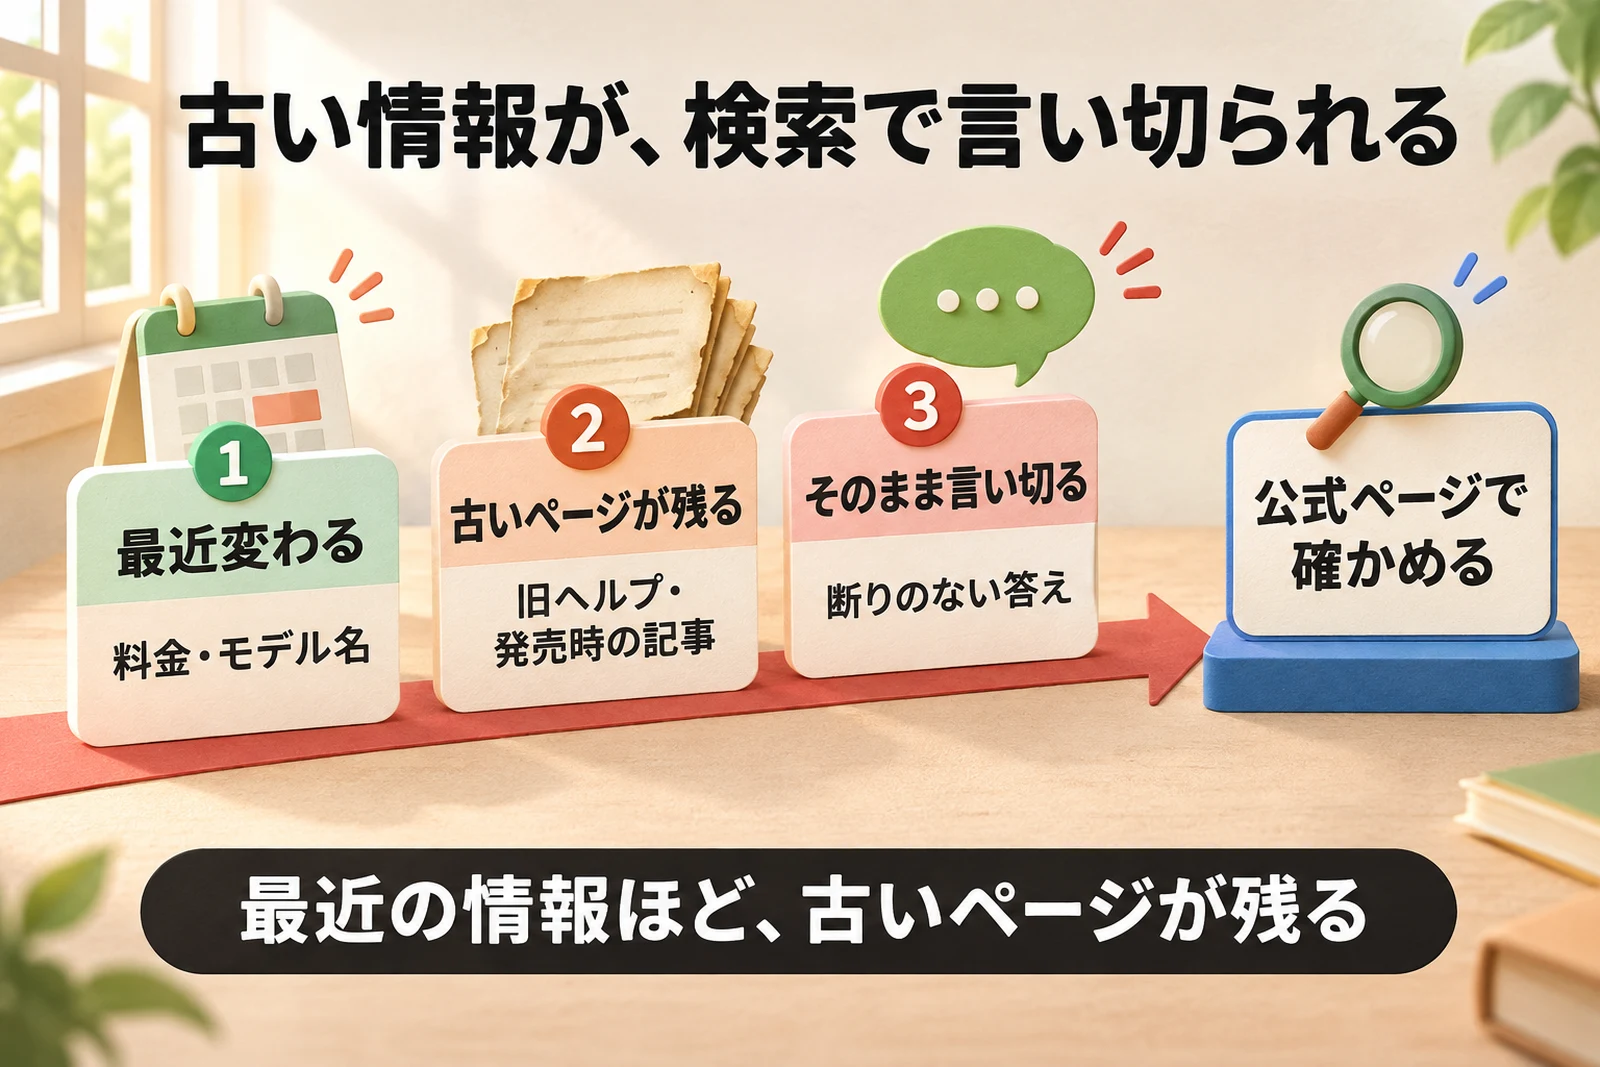
誤りは、どれも検索したうえで、古い情報をそのまま答えたものでした。
Q6 では、無料版の ChatGPT が「無料版のメインモデル GPT-5.6 Luna」と答えました。2026年11月13日の料金ページでは、無料版で使える GPT は GPT-6 Luna と GPT-5 Thinking Mini で、GPT-5.6 Luna は「いいえ」です。
有料の ChatGPT だけは正解で、「一部の公式ヘルプページには旧モデルの『GPT-5.6 Luna』が残っています」と、つまずきの原因まで言い当てました。
Q5 では、無料版の Claude が「日本でのChatGPT Goの月額料金は、1,500円です」と答えました。今の料金ページは ¥1,400 で、1,500円は1月に始まったころの値段です。
引っかけの3問は、作り話ゼロ
存在しない大会・小説・本を聞いた3問は、12回とも「見つからない・確認できない」と答えました。
それらしい優勝者の名前や、あらすじを作った答えは1つもありません。
「AIは知らないことをでっち上げる」という印象は、少なくとも今回の引っかけでは当てはまりませんでした。
無料版は言い切り、有料版は断りを付けた
有料の Claude も Q6 を間違えましたが、「見つかった情報は8月時点のもので、それ以降に変更があったという報道は確認できませんでした」と断りを付けていました。
「いつの情報か」まで断ったのは、この1つだけです。無料版の3つの誤りは、どれも情報の時点を書かずに言い切っていました。
1問1回ずつ、10問だけの小さな実測です。「無料版の誤りは何%」と言えるほどの数ではありません。質問を変えれば結果も変わります。
無料版と有料版は何が違うのか
無料版で動くモデル
料金ページを開いて、プランごとに使えるモデルを確かめました(2026年11月13日)。
| 無料版で使えるモデル | 有料版で増えるモデル | |
|---|---|---|
| ChatGPT | GPT-6 Luna・GPT-5 Thinking Mini | GPT-6 Sol・GPT-6.1 Sol・GPT-6 Astra(Plus・Pro) |
| Claude | Sonnet・Haiku | Opus(Pro から)・Fable |
無料版は、軽いほうのモデルで動いています。 検索は、どちらも無料版から使えます。
 ClaudeとChatGPTを比較|どっちに払う?仕事別の使い分け
正答率は有料のモデルのほうが高い
第三者の Artificial Analysis は、知識の問題でモデルを比べる「AA-Omniscience」という測定を公開しています。
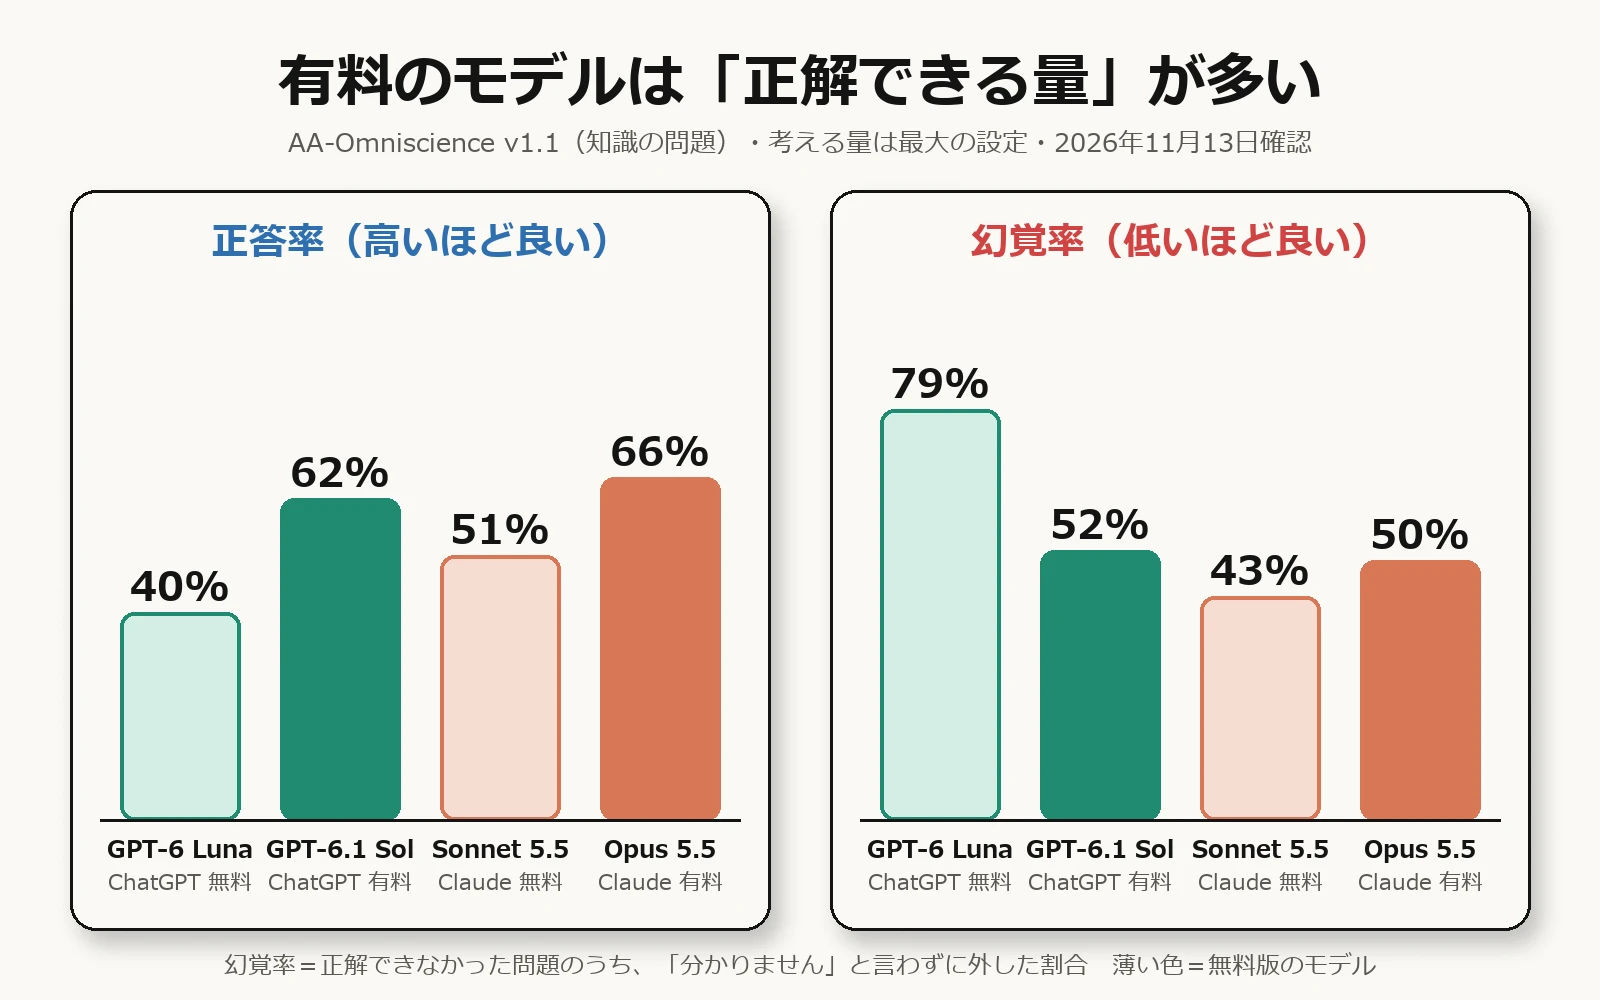
正答率は、無料版のモデルより有料版のモデルのほうが高い結果でした。ChatGPT は 40% と 62%、Claude は 51% と 66% です(どれも考える量を最大にした設定)。
幻覚率は「正解できなかった問題のうち、『分かりません』と言わずに外した割合」です。無料版の GPT-6 Luna は 79% と高めでした。
ハルシネーションは死語?
最近は「ハルシネーションはもう解決した」って聞くんですけど……。
残念ながら死語ではありません。作っている会社自身がそう書いています。
公式も「完全な解決は非常に難しい」と言う
OpenAI は2025年9月の公式記事で、ハルシネーションを「完全に解決するのが非常に難しい問題」と書いています。
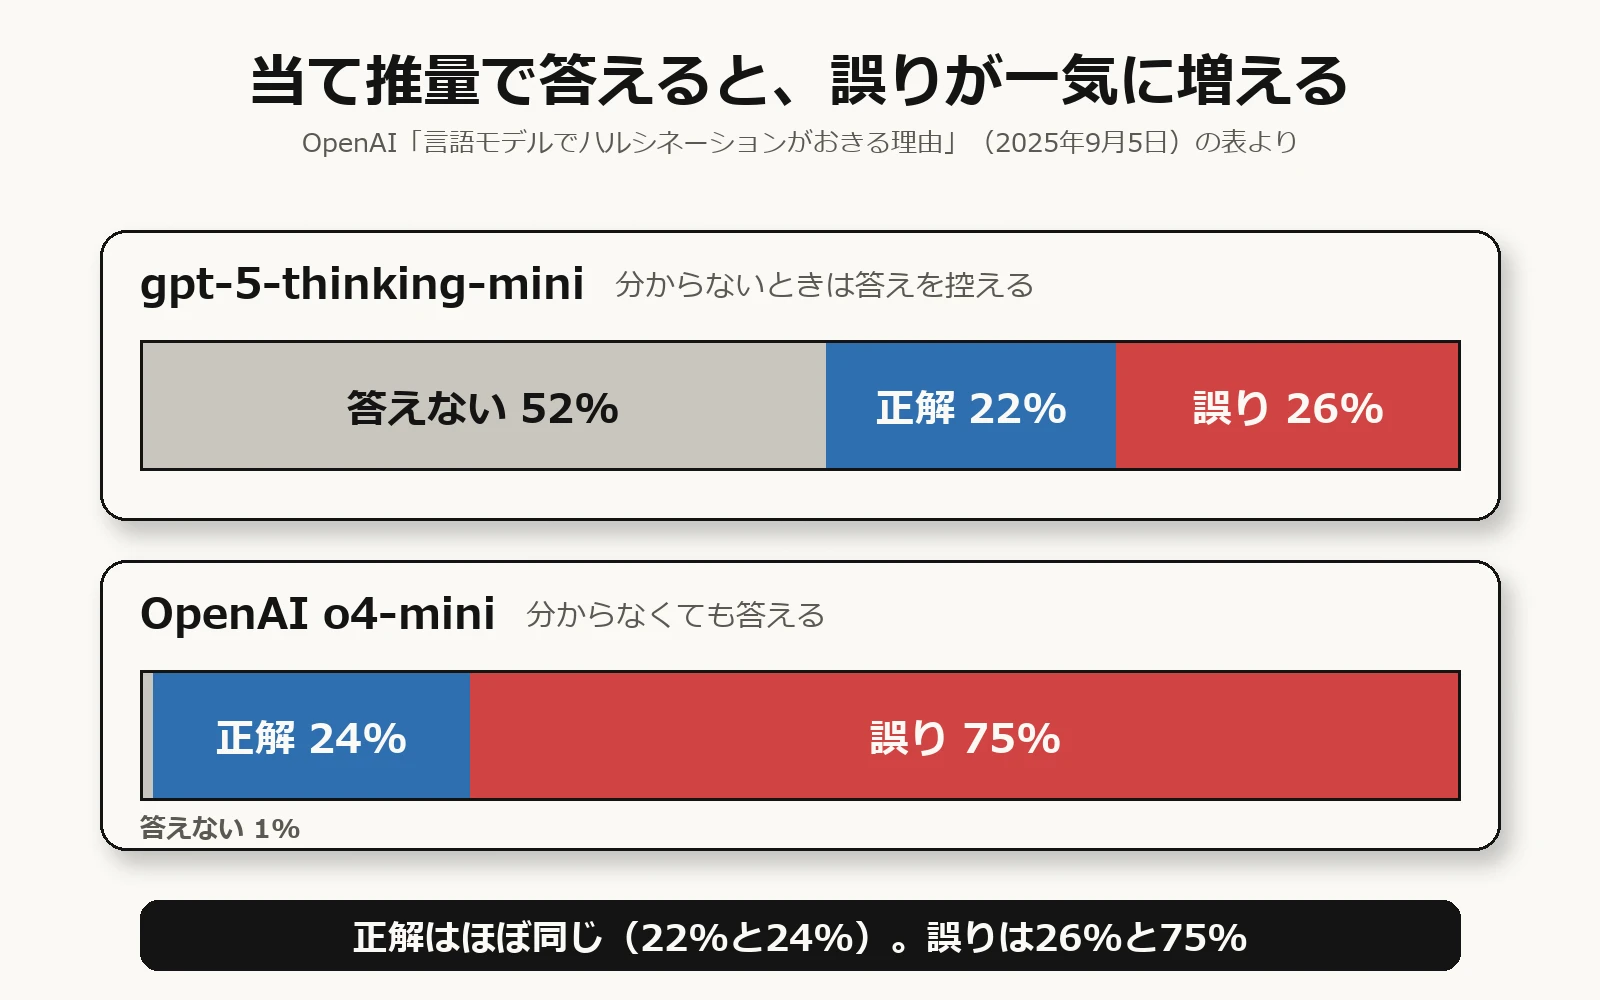
理由は、多くのテストが「正解の数」だけで採点するため、「分かりません」より当て推量のほうが点が上がるからです。
同じ記事の表では、答えを控えたモデルは誤りが26%、当て推量をしたモデルは75%でした。正解の割合はほぼ同じです。
高いモデルほど嘘が少ない、とは限らない
AA-Omniscience の幻覚率は、Claude では上位のモデルほど高くなっていました。
Haiku 5.5 は 34%、Sonnet 5.5 は 43%、Opus 5.5 は 50% です。答えた問題の割合も、60%・76%・87% と上位ほど高くなります。
上位のモデルほど「答える」ので、外れる問題でも答えてしまう、という読み方ができます。
渡した資料を要約させる Vectara の測定でも、GPT-5.4 は nano 3.1% から pro 8.3% へ、上位版のほうが食い違いが多い結果でした(2026年10月22日更新)。
有料版は「正解できる量」が増えます。ただ、外したときに言い切る癖は残るので、大事な数字は確かめる、は有料版でも同じです。
無料版で「AIは嘘つき」と感じやすい理由
心配ごとの1位は「信頼できない」
Anthropic が Claude の利用者 80,508人に聞いた調査(2025年12月)では、心配ごとの1位が「信頼できない」26.7%でした。AI の誤りは、Claude の利用者がいちばん気にしていることです。
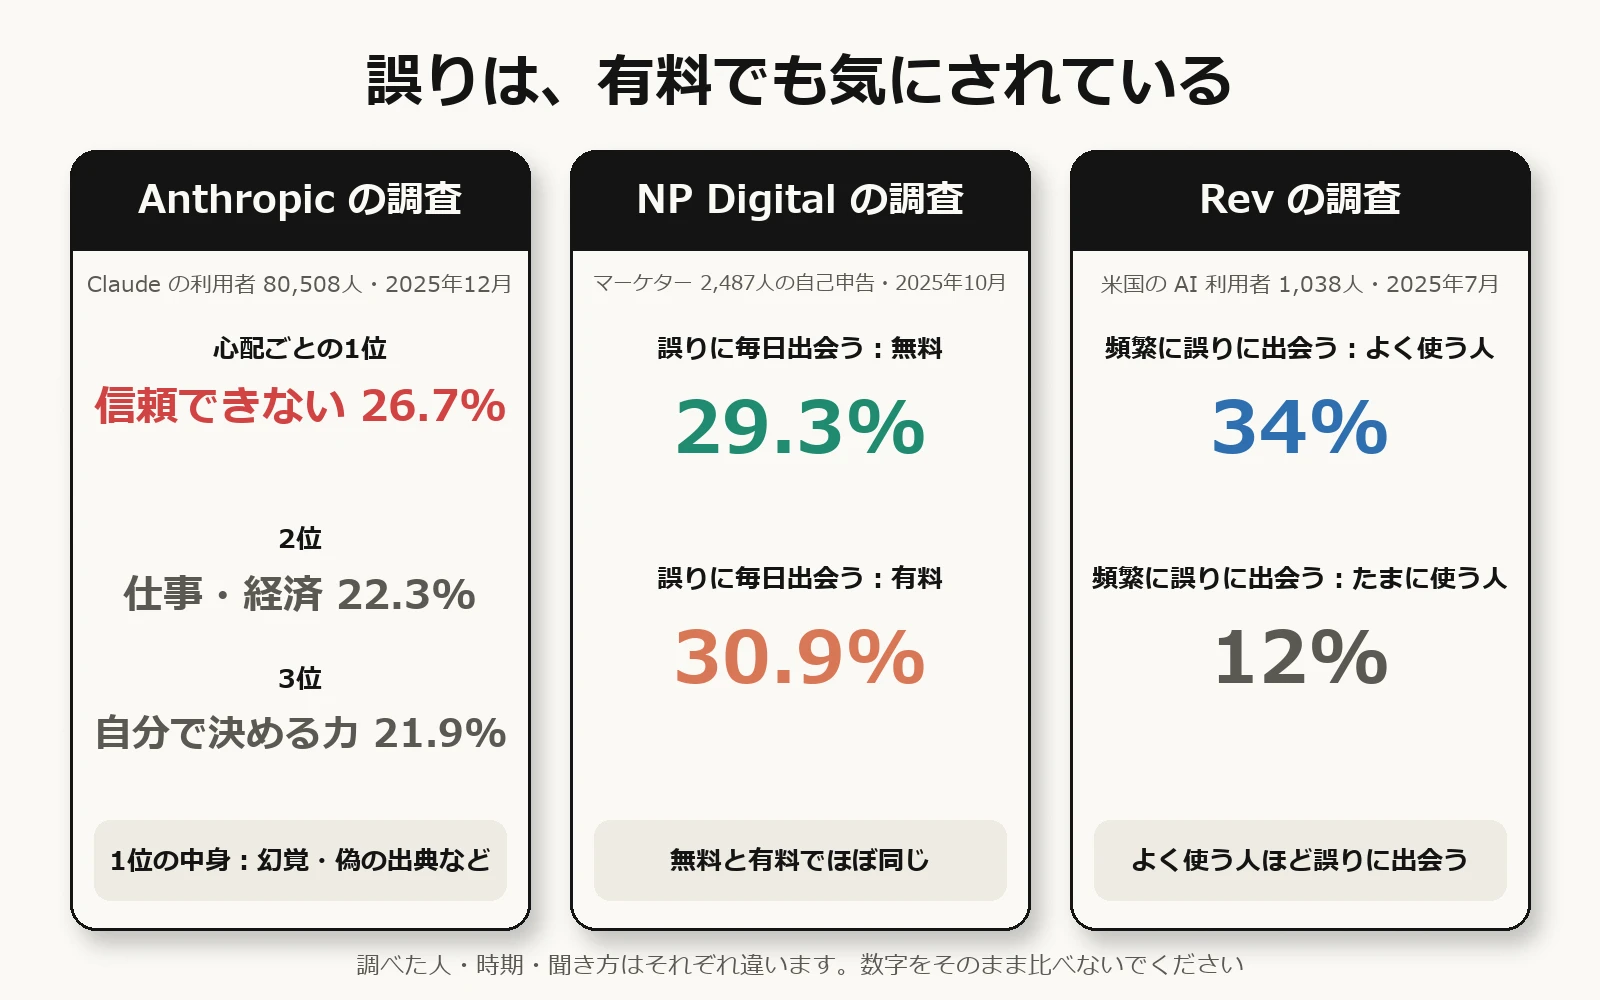
中身は、ハルシネーション・不正確さ・偽の出典・確かめる手間です。仕事や経済への心配(22.3%)より上でした。
有料でも、毎日誤りに出会う人の割合は近い
NP Digital の調査(2025年10月・マーケターの自己申告)では、誤りに毎日出会うと答えた人は、無料 29.3%・有料 30.9% で近い割合でした。「週に数回」は無料 41.3%・有料 48.2% です。
人数はページに 2,487人とありますが、同じ会社の別の報告では 565人と書かれていて、食い違いは確かめられていません。
米国の Rev の調査(2025年7月・1,038人)では、よく使う人ほど誤りに頻繁に出会っていました(34% と 12%)。
Rev は理由として、よく使う人ほど難しいことを頼んでいる、あるいは AI の間違いに気づくのがうまくなっている、という2つの見方を挙げています。有料にしても、誤りに出会わなくなるわけではありません。
無料版は、最新の情報で外れやすい
今回の10問で、断りなしに言い切った誤りは無料版だけでした。
note で無料版と有料版を7つの課題で比べた石塚洋輔さんも、税制の確認で「廃止済みの旧制度」を無料版が現行のように書き、有料版は見抜いたと書いています(2026年10月9日・GPT-5.6 の世代での比較)。
無料版を使っているから AI のハルシネーションを感じて、AI への抵抗感が増えているのではないかと私は考えています。
職場でも、無料版を試して会話が散らかり、使える量も足りずに諦めて AI を嫌いになる、という話を聞きます。
 AI格差とは?使っていない人ほど誤解する理由と縮め方
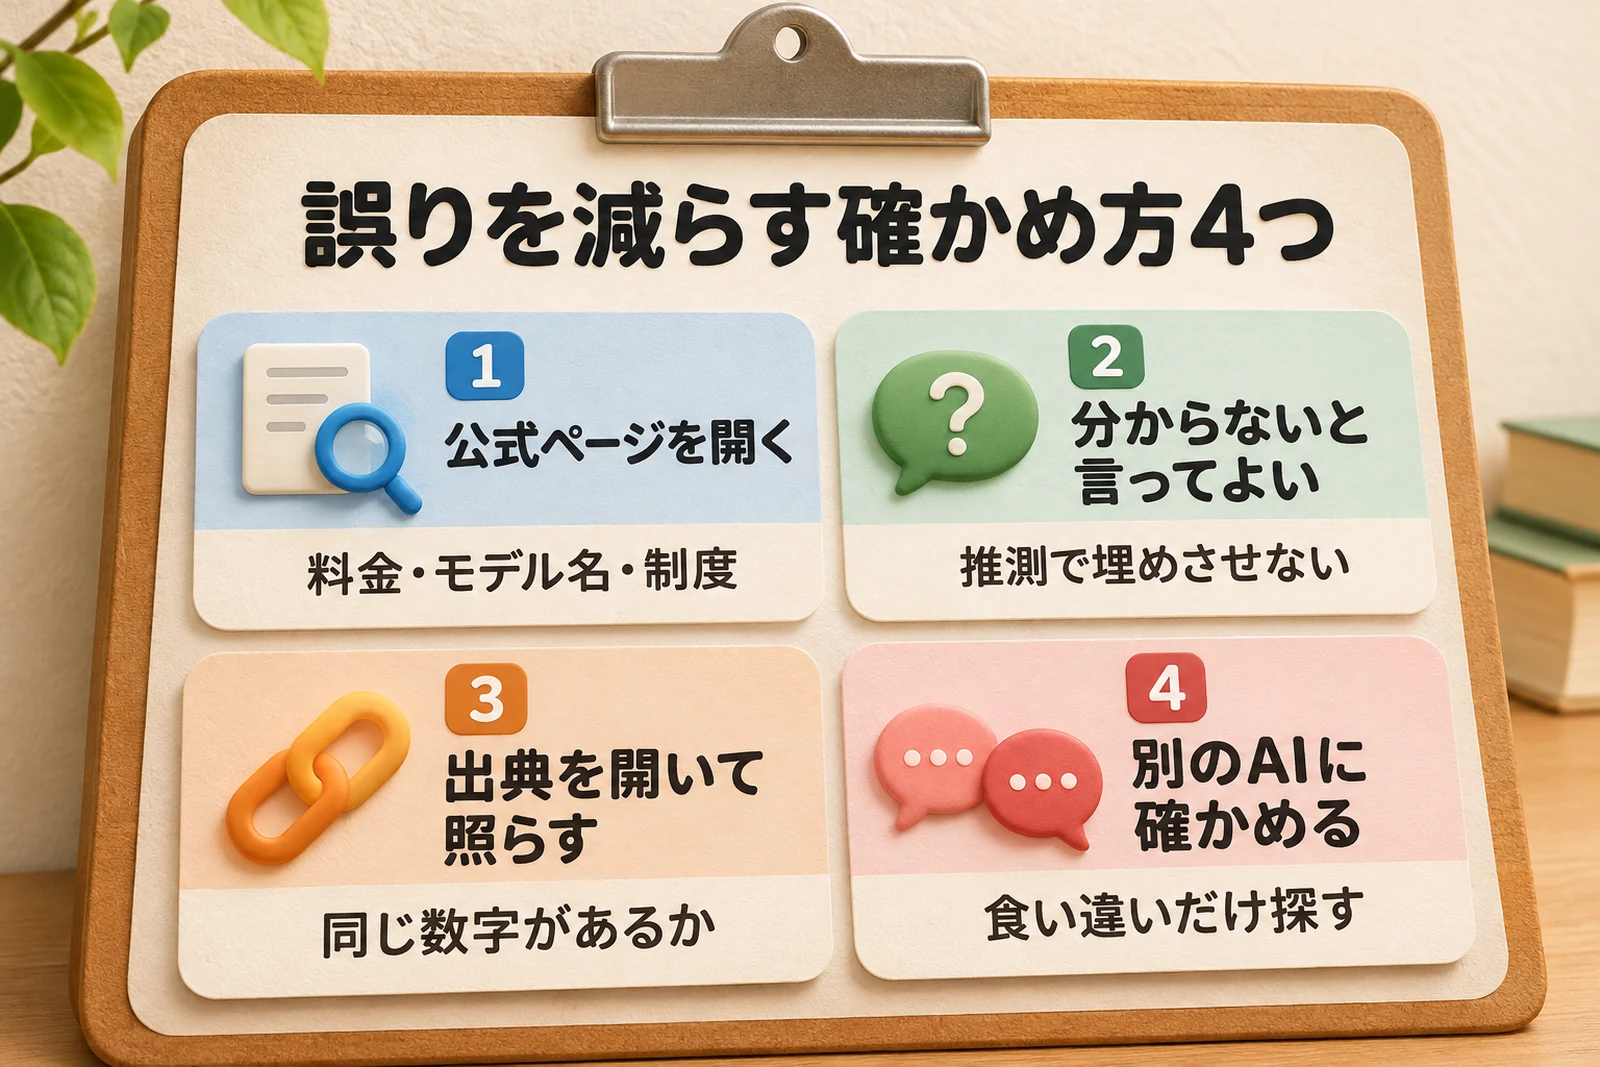
無料版でも誤りを減らす確かめ方
- 最近の事実は公式ページを開く
料金・モデル名・制度のように最近変わる情報は、AI の答えをそのまま使わず、公式ページで確かめます。
- 「分からなければ分からない」と頼む
分からないときはそう答えるよう、頼む文の最後に明示しておきます。
- 出典の URL を開いて照らす
出典の札があっても、開いて同じ数字が載っているかを見ます。
- 大事な文は別の AI にも確かめさせる
書いた AI と別の AI に、食い違いだけを探してもらいます。
最近の事実は公式ページを開く
今回の誤りは、4つとも料金とモデル名でした。最近変わる情報ほど、古いページが検索に残っています。
無料版のモデル名なら、AI に聞くより料金ページを開くほうが早くて確かです。
「分からなければ分からない」と頼む
OpenAI の記事のとおり、AI は当て推量でも答えようとします。質問の最後に一言足しておくと安心です。
分からないことや確かめられなかったことは、推測で埋めずに「分からない」と書いてください。
最近変わった可能性がある情報(料金・モデル名・制度)は、いつの情報かも書いてください。
出典の URL を開いて照らす
今回の Q10 では、4つとも総務省の白書を出典に挙げ、58.8% という数字も白書と合っていました。 私は総務省の公式ページで数字を照らしました(Claude が示した PDF は、開けることだけ確かめ、中身は読んでいません)。
ただ、出典の札が付いていても、Q6 のように古いヘルプが元になることがあります。札があるかではなく、開いて同じ数字が載っているかを見ます。
私の使い方:料金表はマスを1つずつ読む
私は記事に料金やプランの表を写すとき、AI の要約を使わず、ページの表のマスを1つずつ読んでいます。
AI に料金ページを要約させたら、表の空欄とチェックを取り違えたことがあったからです。この読み方に変えてから、順位の取り違えと、「無料プランでも共有できる」という誤読を、公開前に防げました。
 AIのファクトチェックの方法|知識の嘘と操作の嘘を見抜く
よくある質問
有料版にすれば、ハルシネーションは無くなりますか?
無くなりません。 今回の10問でも有料の Claude が1問間違えましたし、利用者の調査でも、毎日誤りに出会うと答えた人の割合は、有料と無料で近い値でした。
ハルシネーションは死語ですか?
死語ではありません。 OpenAI 自身が「完全に解決するのが非常に難しい問題」と書いていて、第三者の測定でも幻覚率が 0% のモデルはありません。
無料の ChatGPT と Claude は、どちらが正確でしたか?
今回の10問では、誤りは ChatGPT 無料が1つ、Claude 無料が2つでした。ただ、10問・1回ずつの差なので、どちらが正確とは言えません。
無料版で嘘を減らす、いちばん簡単な方法は?
料金・モデル名・制度のような最近の情報だけは、公式ページを開いて確かめることです。 今回の誤りは、全部この種類でした。
まとめ
- ChatGPT と Claude の無料版・有料版に同じ10問を聞くと、誤りは「最近変わった情報」だけで、無料版のほうが多く、言い切っていました
- 引っかけの3問は、4つとも作り話をしませんでした
- ハルシネーションは死語ではなく、有料版でも残ります。有料版で増えるのは「正解できる量」です
- 今回の誤りは全部、料金・モデル名のような最近の情報でした。無料版でも、そこだけ公式ページで確かめるのが近道です
無料版で嫌な思いをした方は、まず最近の情報だけ確かめるやり方から試してみてください。
参考資料・出典
公式の資料(2026年11月13日に確認)
- ChatGPT 料金:https://chatgpt.com/ja-JP/pricing/
- Claude 料金:https://claude.com/ja/pricing
- OpenAI「言語モデルでハルシネーションがおきる理由」(2025年9月5日):https://openai.com/ja-JP/index/why-language-models-hallucinate/
- Anthropic「What 81,000 people want from AI」:https://www.anthropic.com/features/81k-interviews
- 総務省「令和8年版 情報通信白書」日本の生成AI利用:https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r08/html/nd111110.html
第三者の測定・調査・発信(2026年11月13日に確認)
- Artificial Analysis「AA-Omniscience」:https://artificialanalysis.ai/evaluations/omniscience
- Vectara「Hallucination Leaderboard」:https://github.com/vectara/hallucination-leaderboard
- NP Digital「How Often Do Free vs. Paid AI Tools Make Mistakes?」:https://neilpatel.com/marketing-stats/error-hallucination-frequency-ai-tools/
- Rev「Heavy AI Users See 3x More Hallucinations」:https://www.rev.com/blog/ai-results
- 石塚洋輔「【検証】ChatGPT無料版が神アップデート!有料版(月額課金)は本当に「もう不要」なのか?」(note):https://note.com/yosuke_ishizuka/n/n5ac8764e5fa0