「AI を使えば簡単でしょ」
職場で、こう言われることがあります。
毎日 AI を使っている私からすると、この一言には大事なことが抜けています。 どのモデルで、何をしようとしているのかです。
公的な調査と海外の研究、私の体験を並べると、AI格差の正体が見えてきます。
AI格差は「使うかどうか」だけでなく、どのモデルで・何を・どう使うかの差です。しかも、ある実験では、損をした側はそれに気づいていないようでした。
差に関わるのは、生まれつきの能力より、使えるモデルや分野の知識、そして使い方だと私は考えています。自分の仕事を1つ決めて、確かめながら何度も直すことから、差は縮められます。
目次
AI格差とは?「使うか」だけでなく「どう使うか」の差

AI格差って、AI を使う人と使わない人の差のことですか?

それもあります。ただ、毎日使っていると、使う人どうしの差のほうが大きいと感じています。
AI格差は、AI を活用できる人と、できない人の間に生まれる差のことです。 「AIデバイド」とも呼ばれます。
まずは、日本の今を数字で見てみます。
日本は1年でほぼ倍、それでも4か国でいちばん低い
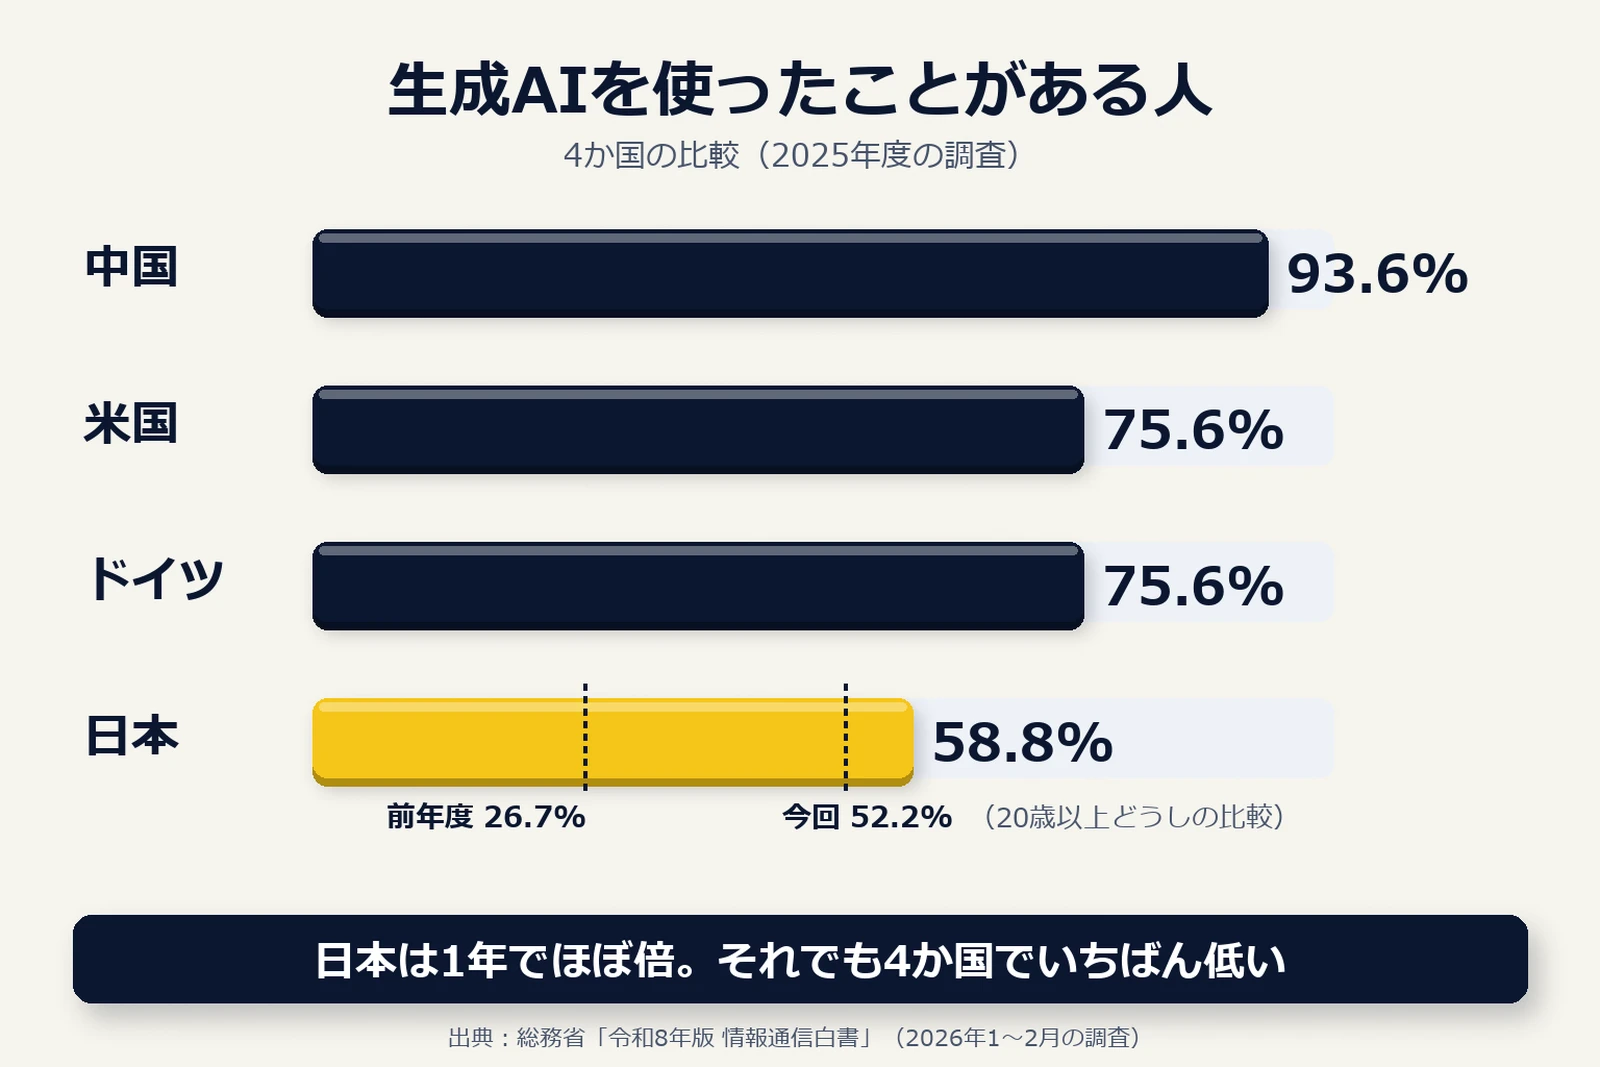
総務省の「令和8年版 情報通信白書」によると、生成AIを使ったことがある人は、日本で58.8%でした。 今回から15〜19歳が調査に加わったので、前の年と同じ20歳以上でくらべると、26.7%から52.2%です。
同じ条件でも、1年でほぼ倍に増えています。
それでも、米国とドイツは75.6%、中国は93.6%です。 4か国の中で、日本がいちばん低い結果でした。
年代で3倍近い差がある
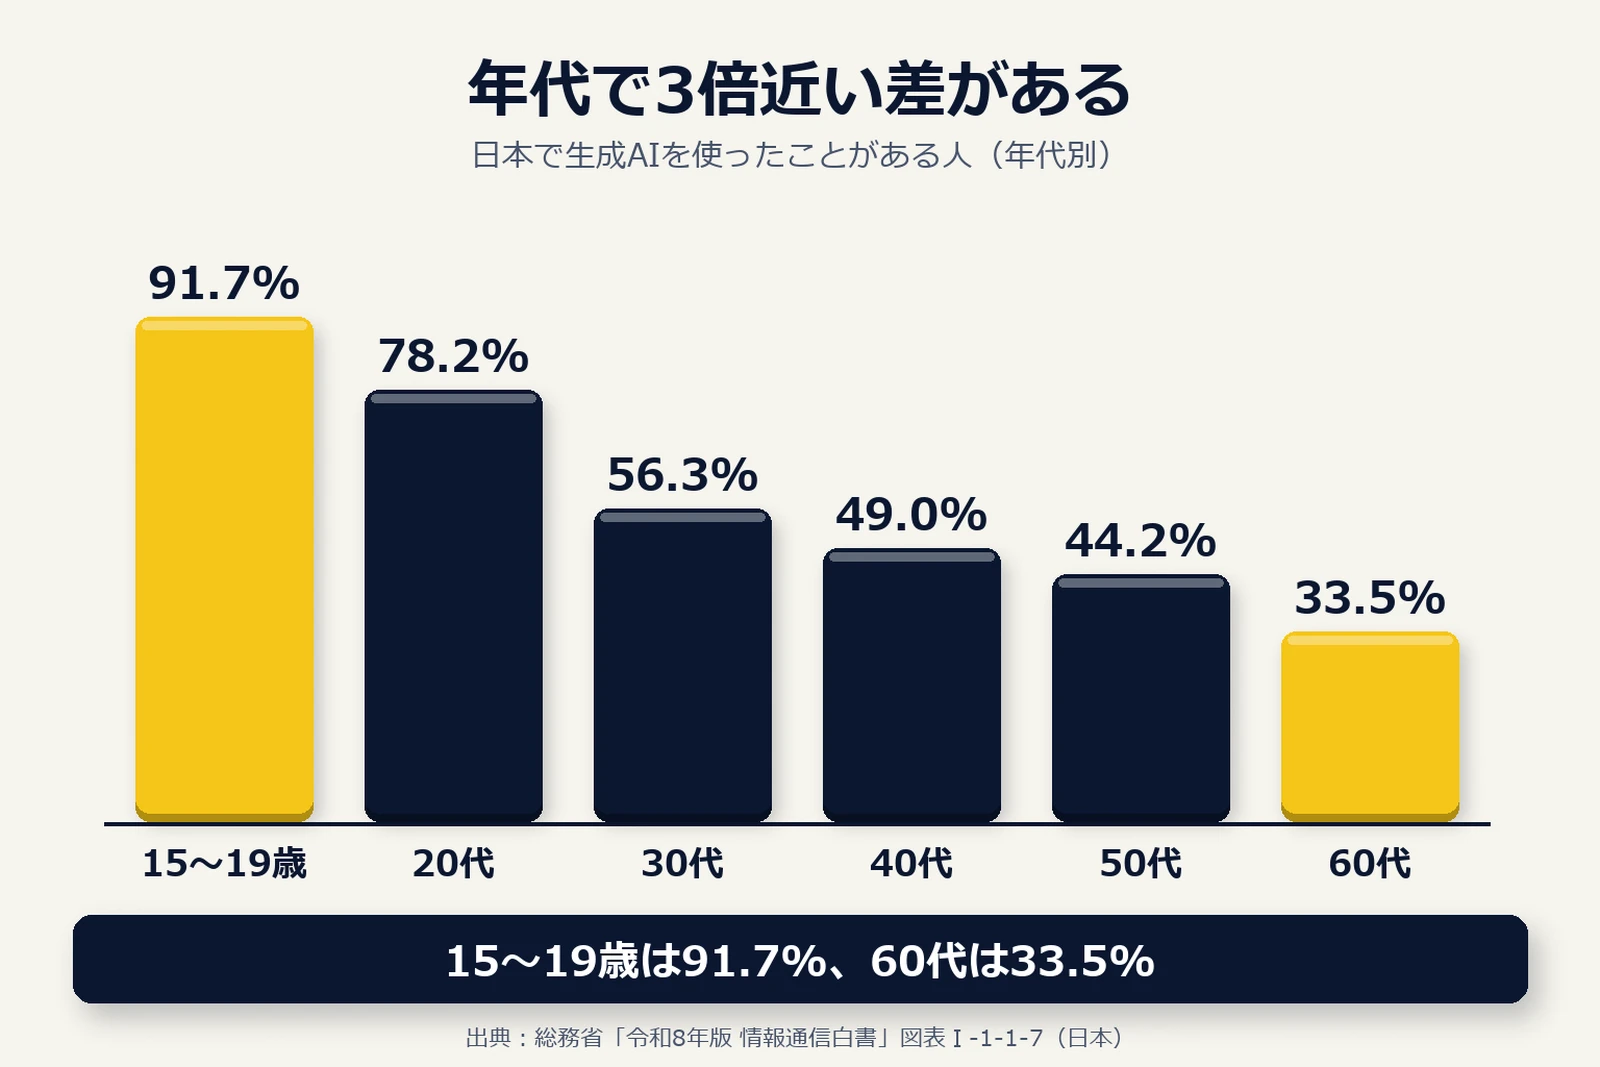
年代別に見ると、15〜19歳は91.7%、60代は33.5%でした。 同じ日本の中でも、年代で3倍近い差があります。
使う頻度にも差があります。 「ほぼ毎日」使う人は日本で約3割で、ほかの3か国は4割を超えていました。
使わない理由の2位は「使い方がわからない」
文章を作る生成AI(テキスト生成AI)を使っていない人に理由を聞くと、1位は「自分の生活や業務に必要ない」で42.4%でした。 2位は「使い方がわからない」で、38.8%です。
「使い方がわからない」の割合は、4か国で日本がいちばん高い結果でした。 差は、使うかどうかの手前の「使い方」から始まっています。
調査は2026年1〜2月に、日本・米国・ドイツ・中国で行われました。4か国とも今回から15〜19歳が対象に加わっています(2026年10月18日に総務省のページで確認)。
使っていない人ほど AI を誤解している
使っていない人の AI の見方は、大きく2つに分かれると感じています。 低く見る人と、何でもできると高く見る人です。
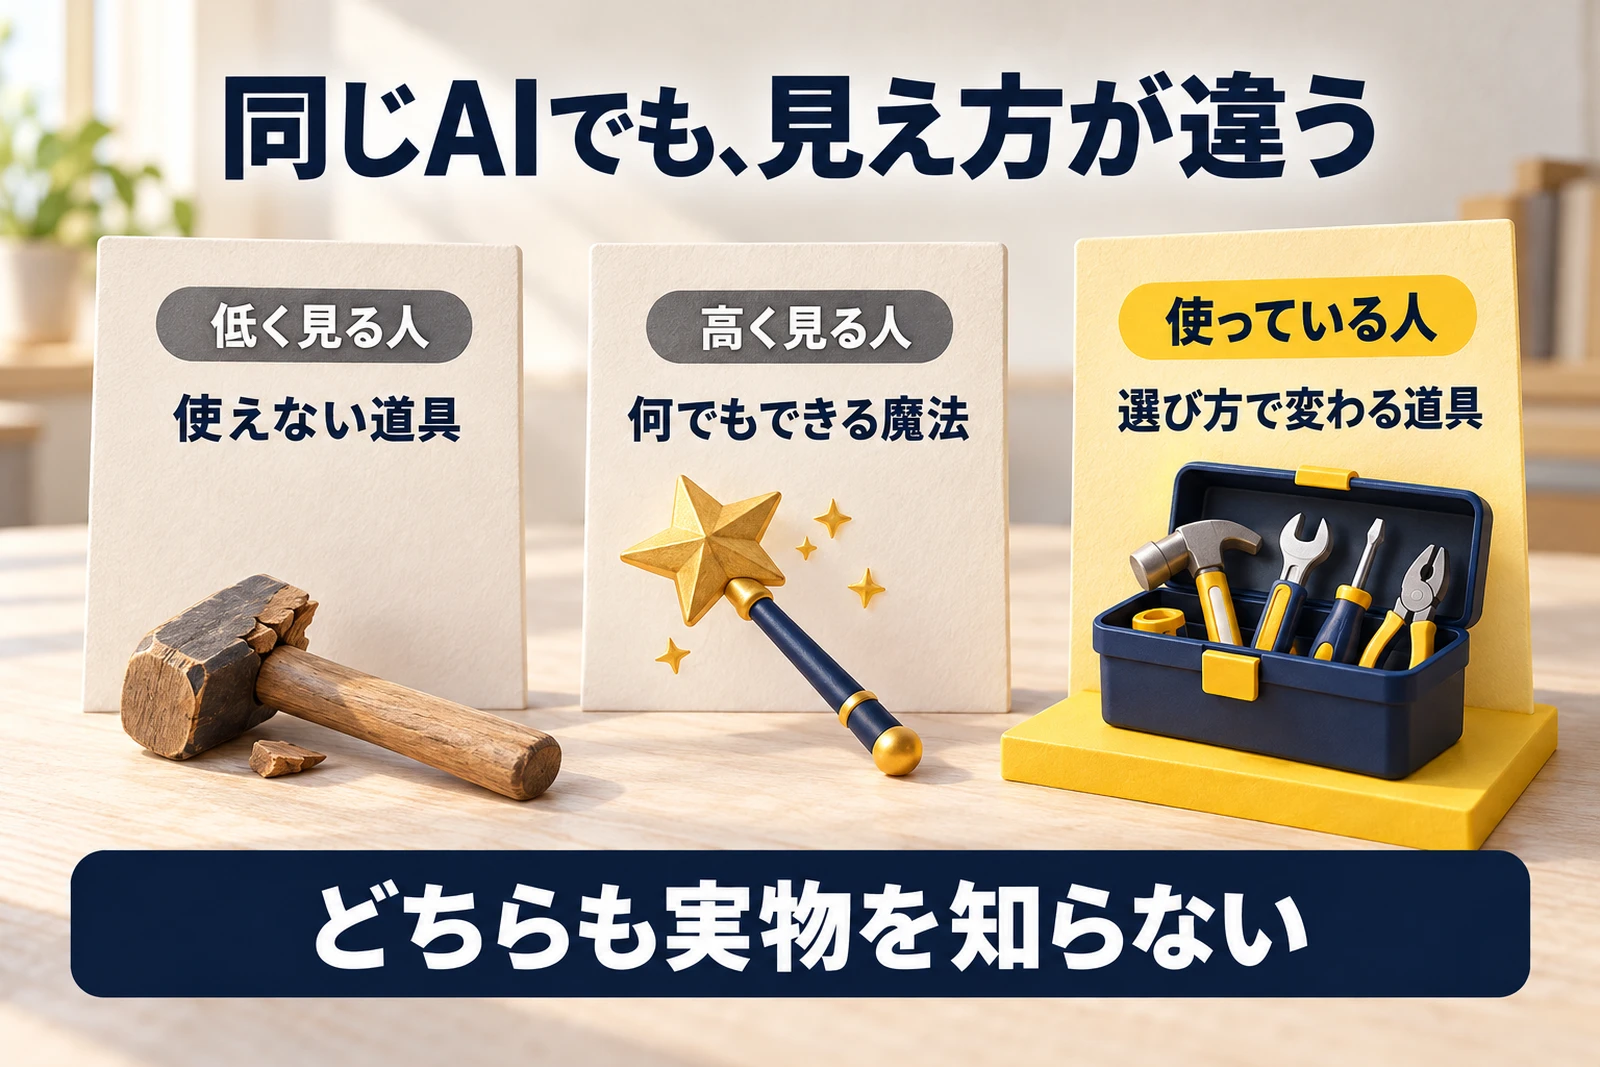
図は、私が周りとの会話で感じてきた見え方を絵にしたものです。
低く見る人:無料版の古い印象のまま
元 OpenAI の研究者の Andrej Karpathy 氏は、2026年4月の X の投稿で、AI の力の受け止め方に差が広がっていると書きました。 去年の無料版を試した印象のまま、AI を判断している人が多いという指摘です。
一方で、有料の最新のエージェント(Codex や Claude Code)を仕事で使う人は、その進歩に驚いている。 同じ「AI」という言葉で、まったく違うものを見ているという話です。
職場でも、似た声を聞きます。 無料版を試し、会話が長くなって話がかみ合わなくなり、使える量も足りなくなって、諦めて AI を嫌いになる。
高く見る人:何でも簡単にできると思っている
反対に、AI を「何でも簡単にできるもの」と思っている人もいます。 職場で言われる「AI を使えば簡単でしょ」は、こちらです。
以前、職場の掲示物を AI で作ったことがあります。 上司には「業者なんかいらないね」と言われました。
でも、外に見せられる品質にするまでには、何度も指示を出し直しました。 AI を使わない同僚からは「AI=簡単」と誤解され、急に頼まれたり、「ちょっと直すだけでしょ」と言われたりしました。
どちらも「どのモデルで何をするか」を知らない
低く見る人も、高く見る人も、実物を知らない点は同じです。
どのモデルで、何を、どこまで任せるのか。 そこが見えていないと、AI は「使えない道具」か「魔法」のどちらかに見えてしまいます。
使っていない人がどれだけ AI を高く見ているかを、直接数えた調査は見当たりませんでした(2026年10月時点)。 ここは、私の実感です。
使っていない人ほど、AI を AGI(人と同じように何でもこなす AI)のように、簡単に何でもできるものの総称としてとらえていると感じます。
実際には、扱い方を覚え、アイデアを出し、何度も直す努力が要ります。作業は楽になっても、確認とアイデアは人間が行います。
差は気づかないうちに広がる
差は「漏斗」のように開いている
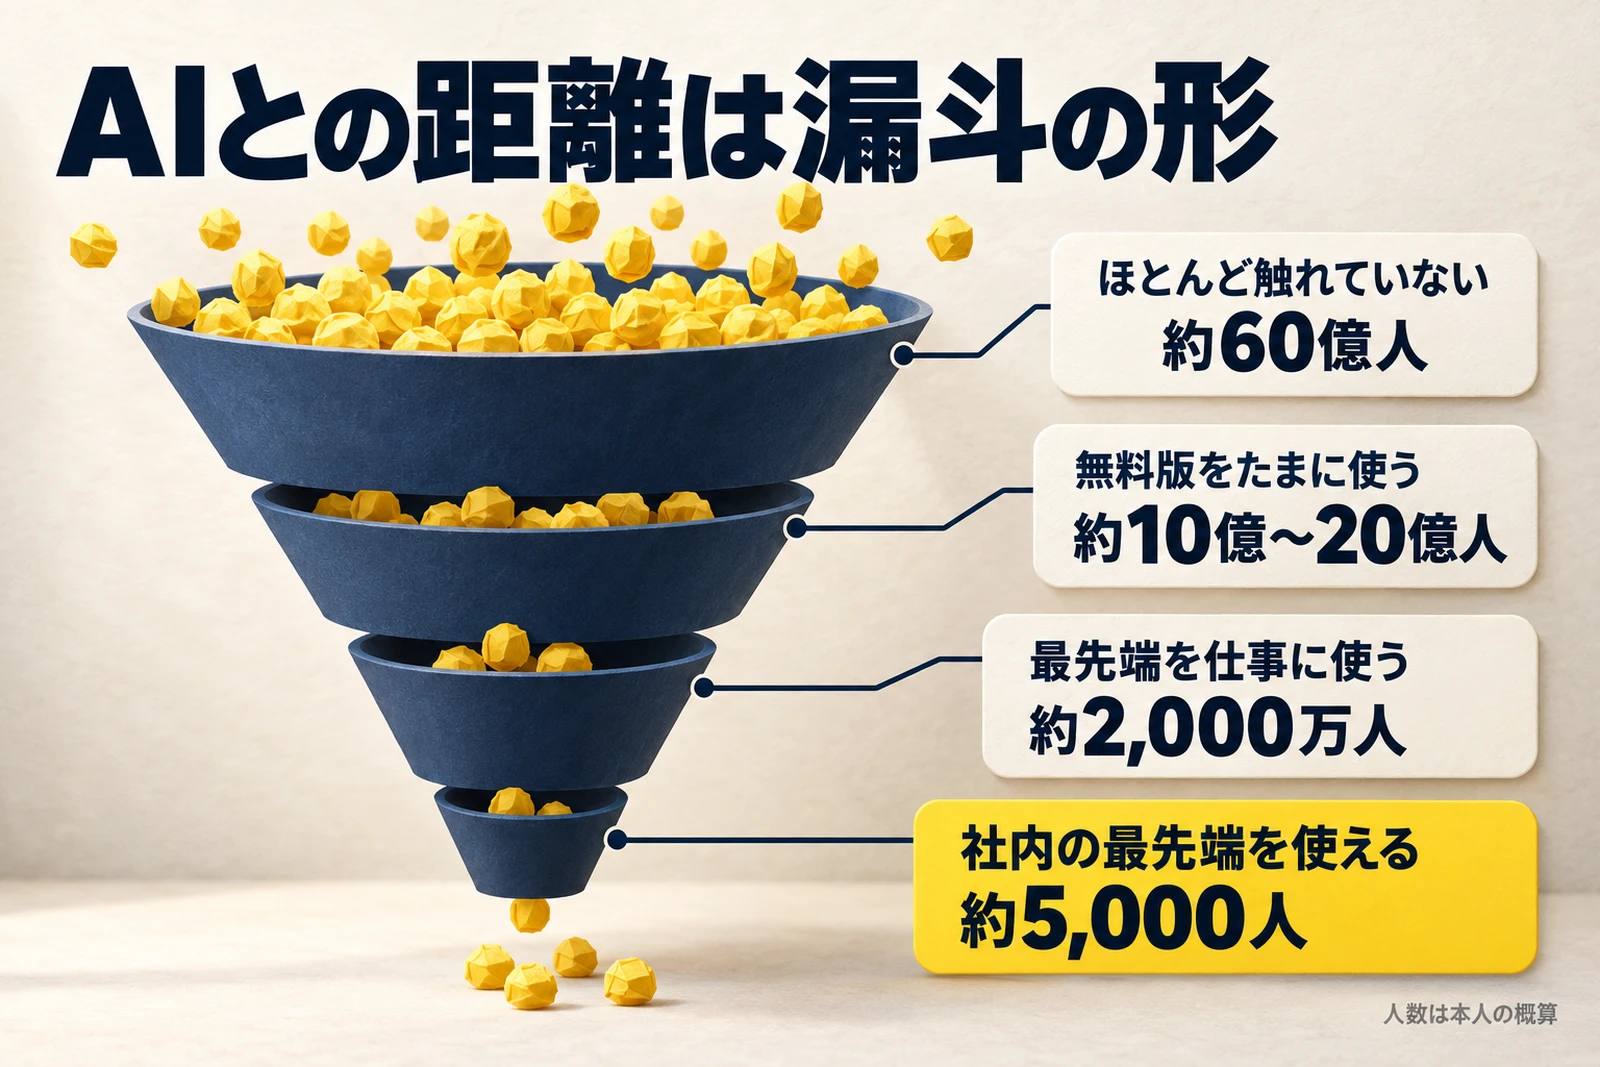
Karpathy 氏は2026年10月、4月の投稿を引き直して、差はさらに広がっていると書きました。 いまは「2つのグループが噛み合わない」というより、先に行くほど細くなる漏斗のようだ、と。
本人の大まかな見積もりは、上の図のとおりです。 調査の結果ではなく、本人の概算です。
差を生むのは「任せる課題の大きさ」「分野ごとの得意・不得意」「無料・有料・社内のどれを使えるか」だと説明しています。
性能の高いモデルのほうが得をしたのに、満足度の差は見えなかった
Anthropic は、社員69人の Claude どうしに、社内でフリーマーケットをさせる実験「Project Deal」を行いました。 人の手を介さずに売り買いさせ、本番の回では186件の取引が成立しています。
実は、同じ市場を4つ同時に動かしていました。 品物を実際に交換した本番の回は、全員が高性能な Claude Opus 4.5 です。
研究用の別の2回では、参加者には知らせずに、半分の確率でいちばん小さい Claude Haiku 4.5 を割り当てて比べました。
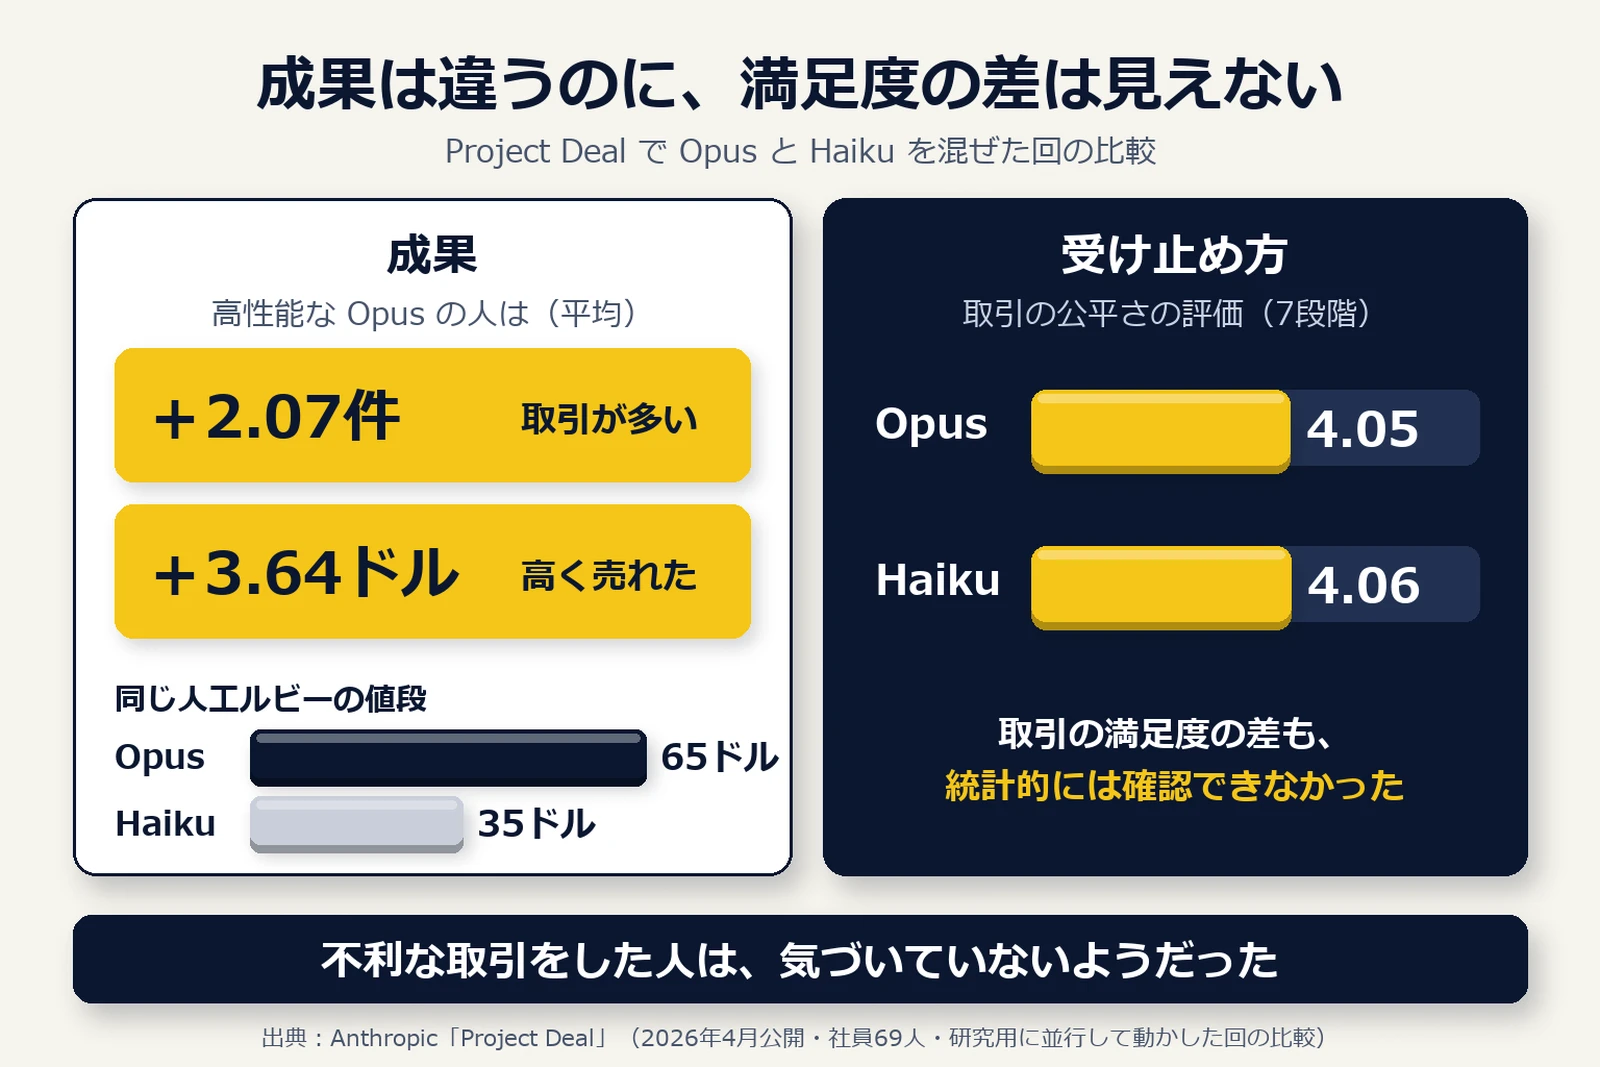
比べた回では、Opus の人のほうが取引が平均2.07件多く、同じ品を売ると平均3.64ドル高く売れました。 例えば、同じ人工ルビーが Opus では65ドル、Haiku では35ドルでした。
それなのに、取引の満足度の差は、統計的には確認できませんでした。 取引の公平さの評価も、7段階で4.05と4.06で、ほぼ同じです。
Anthropic は、不利な取引をした人がそれに気づいていないようだったと書いています。 現実の市場で同じ差が起きれば、損をする側は気づかないかもしれない、とも。
比べたのは無料版と有料版ではなく、性能の高いモデルと軽いモデルです。 参加者は Anthropic の社員なので、そのまま一般の人に当てはまるとは限りません。
ただ、無料版では軽いモデルや少ない量しか使えないことが多いので、無料版で満足している人にも同じことが起きうると私は考えています。
仕事の場でも差が開いている
帝国データバンクの調査(2026年3月・1万312社)では、生成AIを活用している企業は34.5%でした。 活用している企業に悪影響を聞くと、「使いこなし格差の拡大」が18.8%ありました。
会社と会社の間だけでなく、同じ会社の中でも差が開いているということです。
マサチューセッツ工科大学(MIT)の研究チームは、2025年8月に報告書「The GenAI Divide」を出しました。 米国の経済誌 Fortune の記事によると、調べた企業の試し導入のうち、約95%が目に見える収益につながっていなかったそうです。
これは報告書が調べた範囲の数字で、すべての企業に当てはまる失敗率ではありません。
お金を払って入れるだけでは、差は縮まりません。MIT の報告書は、原因を AI の性能ではなく、道具も組織も仕事に合わせて育っていない「学びの差」だとしています。
私が見てきた差
サイトが下火になって、AI に出会った
私は Web サイトの運営を6〜7年続けてきました。 パソコンに詳しいわけでも、コードを書けるわけでもなく、独学で月5〜10万PVのサイトを作りました。
でも AI が広まるにつれて、運営していたサイトは少しずつ下火になりました。 そこで出会ったのが、Claude や ChatGPT でした。
お金をかけて、初めて性能の差を知った
最初にお金をかけたのは、Gemini でした。 お金をかけることで性能が上がることを、そこで初めて知りました。
そこから Claude や Codex を使い始め、AI エージェント(自分で作業を進める AI)にのめり込みました。 いまは仕事と Web サイトの運営で、毎日5〜15時間ほど AI を使っています。
2か月進まなかった勤務表が、5日でたたき台に
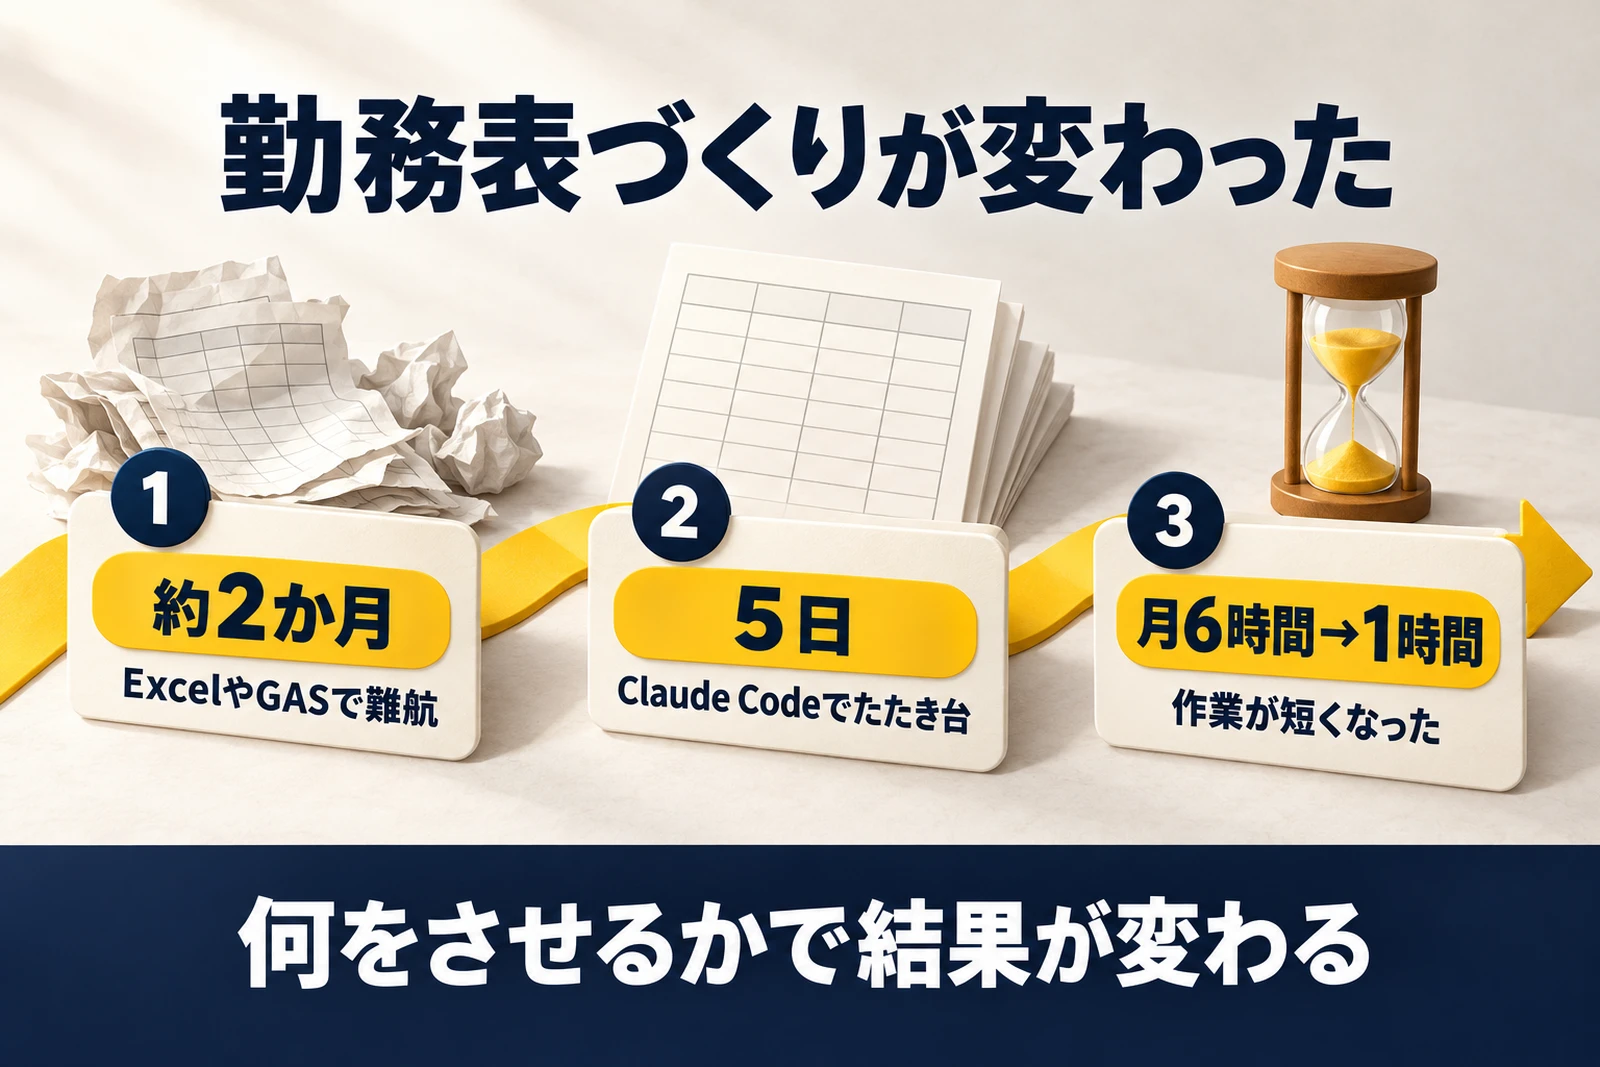
職場の勤務表(シフト)づくりでは、Excel や GAS(Google の自動化の仕組み)、いろいろな AI を試して、約2か月うまくいきませんでした。 Claude Code に替えたところ、5日でたたき台ができました。
作業は月6時間から1時間になりました。 同じ「AI」でも、どのモデルで何をさせるかで、結果はまったく違うと実感した出来事です。
選択肢が増え、たくさんのことが自動化されました。そのぶん、差をつける難しさと、アイデアの大切さを感じています。
差は使い方で縮められる
ここまで読むと、差は広がる一方に見えるかもしれません。 でも研究を見ると、AI は使い方しだいで、能力の差を縮める道具でもあります。
新人や平均より下の人ほど伸びた
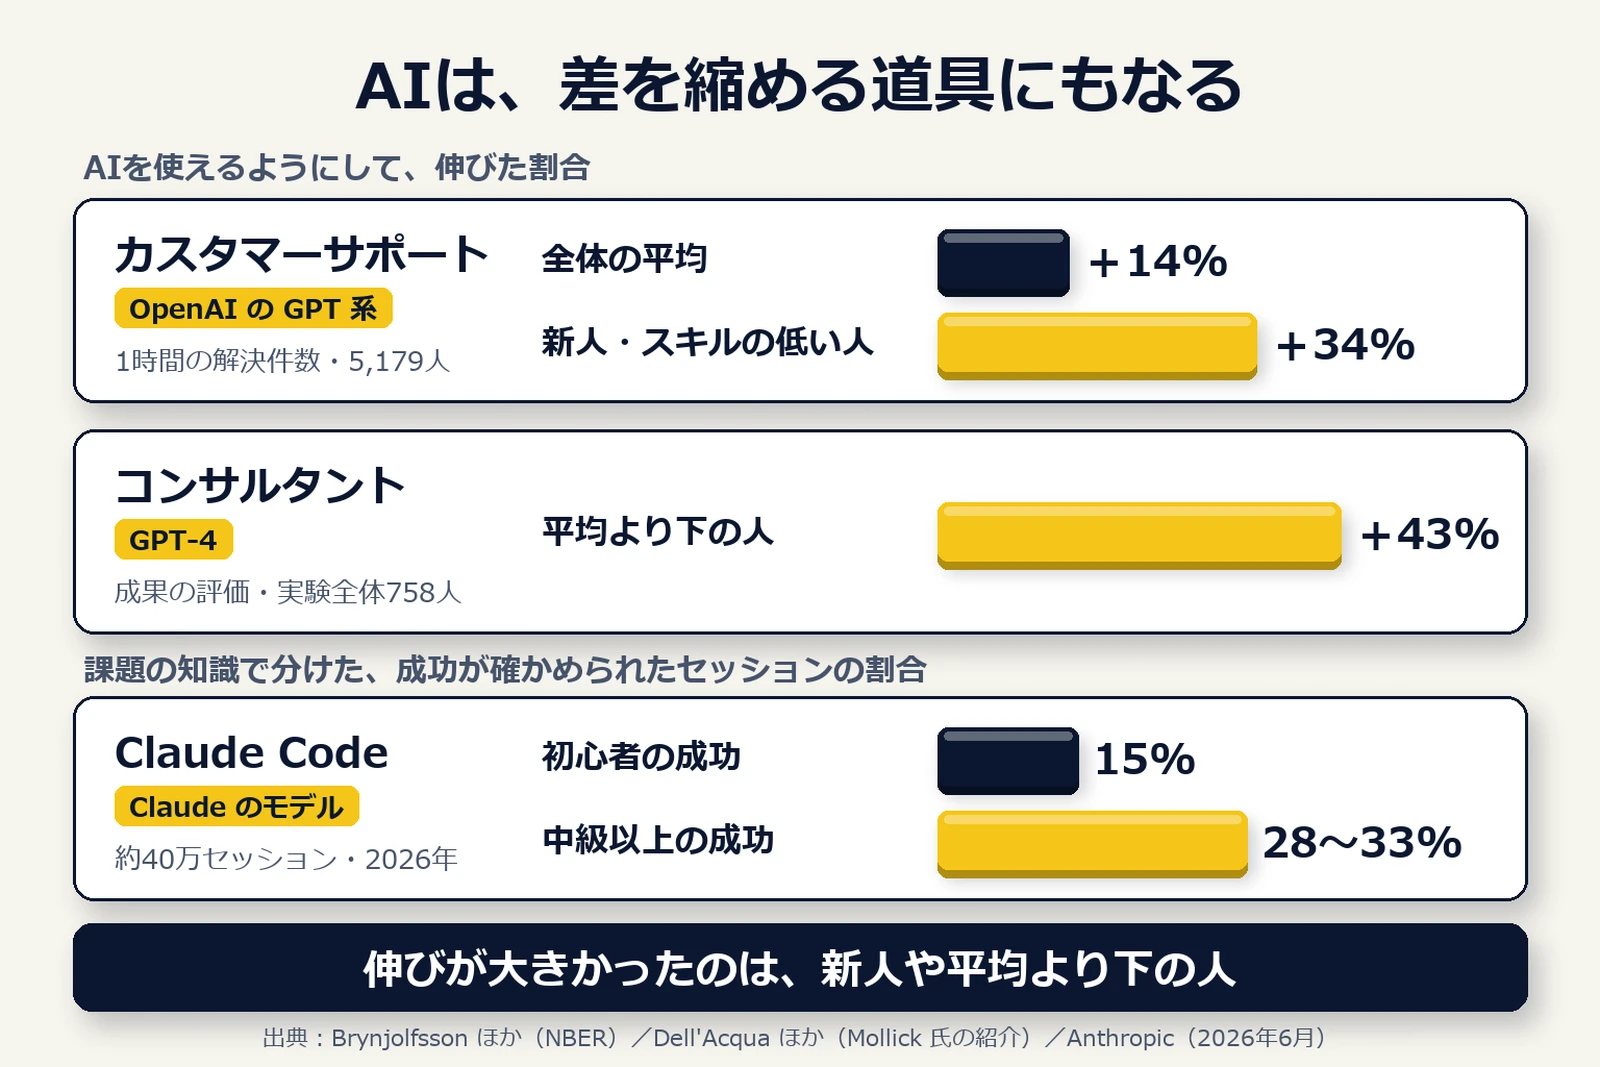
ある企業のカスタマーサポート担当者5,179人を調べた研究(Brynjolfsson 氏ら・2023年)では、OpenAI の GPT 系のモデルで作った手助けの道具を使えるようにすると、1時間に解決できる件数が平均14%増えました。 新人やスキルの低い人は34%伸び、経験のある人はほとんど変わりませんでした。
コンサルタント758人を対象に、GPT-4 を使える人と使えない人などを比べた実験(Dell'Acqua 氏ら・2023年)でも、成果の評価で平均より下の人がいちばん伸びました(43%)。 ただし AI が苦手な課題では、AI を使った人のほうが正答率が下がっています。
この2つは2023年に発表された研究で、使われたのは当時のモデルです。
コードを書けなくても、仕事を知っている人が強い
Anthropic は、Claude のモデルを使う Claude Code の約40万セッションを分析しました(2026年6月公開)。 計画の判断の約70%は人が行い、実行の判断で人が決めたのは約20%でした。
その課題についての知識で分けると、成功が確かめられたセッション(いちばん厳しい基準)は、初心者で15%、中級以上で28〜33%でした。 ソフトウェアの職の人とほかの職の人の差は小さく、コードを作るセッションで34%と29%です。
差を分けるのは職種より、その分野の知識と使い方ということです。
同じ AI でも、助言の選び方と実行の仕方で差がついた
ケニアの起業家に、GPT-4 の経営相談の相手を使ってもらった実験があります(ハーバード大学ほか・2023年)。 平均では効果が見られず、もともと成績の良い人は15%強よくなり、悪い人は約8%悪くなりました。
差を生んだのは、助言のどれを選び、どう実行したかでした。
Anthropic の「AI Fluency Index」(2026年2月)でも、やり取りを重ねて磨く会話ほど、上手な使い方が多く見られました。 一方で、AI に成果物を作らせる会話では、理由を問い直したり、足りない前提を見つけたりする行動が少なめでした(会話の中で見える行動だけを数えた結果で、原因までは分かっていません)。
差を縮めるのは、AI に丸投げすることではありません。選んで、確かめて、直すことです。
差を縮める最初の一歩
結局、何から始めればいいんですか?
大きなことからではなく、毎週くり返している仕事を1つ選ぶところからです。
- 自分の仕事を1つ決める
「何でもやってもらう」ではなく、毎週くり返している作業を1つ選びます。
- 性能の高いモデルで試す
無料版で諦める前に、上位のモデルも試します。同じ作業で、直す手間・誤り・使える量をくらべ、楽になったら続けます。会話が長くなったら、新しい会話に分けます。
- 何をやるかは自分で決めて頼む
目的・順番・できあがりの形は自分で考え、作業を AI に任せます。
- 結果を確かめる
数字や事実は、元の資料や実物で確かめます。
- 何度も直して、仕組みに育てる
1回で完成させず、直したことや失敗を記録して、次に生かします。
私がしている4つの工夫
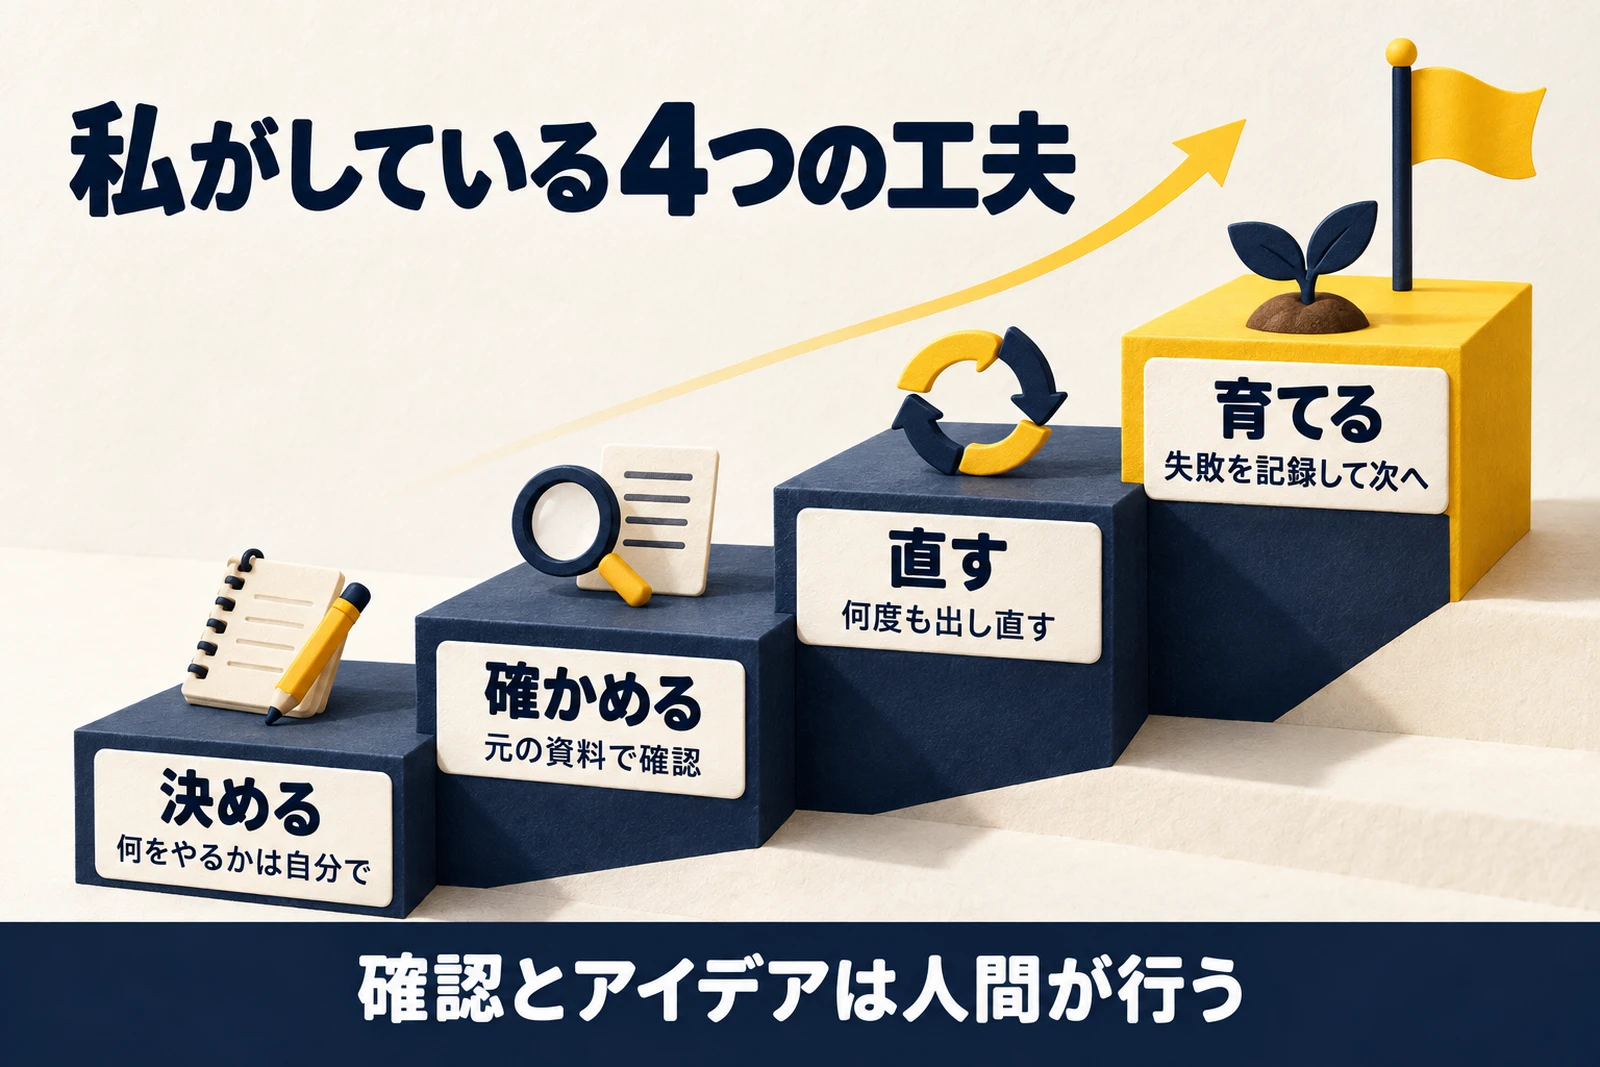
- 何をやるかを自分で決める:勤務表は、上司に掛け合い、同僚の話を聞きながら作り直してきました。
- 結果を確かめる:この Lab の数字は、公式のページを開いて確かめています。この記事でも、要約が文字化けで読み違えた数字を、元のページで確かめ直しました。
- 何度も直して磨く:職場の掲示物は、何度も指示を出し直して仕上げました。
- 仕組みを作って育てる:失敗の記録と決まりを AI に読ませて、同じ失敗を減らしています。
どれも、AI が代わりにやってくれることではありません。 確認とアイデアは人間が行う、というのが私の使い方の芯です。
有料のプランを比べるときは、こちらの記事が参考になります。
 生成AI比較|無料・5000円まで・1万円以上のおすすめ
よくある質問
AI格差とは何ですか?
AI を活用できる人と、できない人の間に生まれる差のことです。 「使うかどうか」だけでなく、「どのモデルで何をどう使うか」でも差がつくと私は考えています。
今から始めても遅くないですか?
遅くありません。 研究では、新人や平均より下の人ほど、AI で大きく伸びました(カスタマーサポートの1時間あたりの解決件数で34%、コンサルタントの成果の評価で43%)。
有料版にしないとダメですか?
必ずではありません。無料版で足りる使い方もあります。 ただ、Project Deal では性能の高いモデルのほうが得をしても、満足度の差は確認できませんでした。無料版だけで判断せず、一度は上位のモデルを同じ作業で試し、直す手間や誤りがどう変わるかをくらべるのがおすすめです。
何から始めればいいですか?
毎週くり返している仕事を1つ決めて、AI に頼み、結果を確かめて直すことからです。 1回で完成させず、何度か直すつもりで始めてください。
まとめ
- AI格差は「使うかどうか」だけでなく、どのモデルで・何を・どう使うかの差
- 私の周りでは、使っていない人ほど、AI を低く見るか、何でもできると高く見るかのどちらかに感じる
- 差には使えるモデルや分野の知識、使い方が関わる。Project Deal では、損をした側がそれに気づいていないようだった
- 研究では新人や平均より下の人ほど伸びた。使い方を変えれば縮められる
AI に少しでも触れる機会があれば、選択肢はきっと増えます。 まずは1つの仕事から、確かめながら試してみてください。
参考資料・出典
公式・調査(2026年10月18日確認)
- 総務省「令和8年版 情報通信白書」個人における生成AIサービスの利用経験(日本):https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r08/html/nd111110.html
- 同(米国・ドイツ・中国):https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r08/html/nd111120.html
- 同(生成AIサービスを利用しない理由):https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r08/html/nd111220.html
- 同(年齢階層):https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r08/html/nd111310.html
- 同(利用頻度):https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r08/html/nd111320.html
- 帝国データバンク「生成AIに関する企業の動向調査」:https://prtimes.jp/main/html/rd/p/000001336.000043465.html
- Anthropic「Project Deal: our Claude-run marketplace experiment」:https://www.anthropic.com/features/project-deal
- Anthropic「Agentic coding and persistent returns to expertise」:https://www.anthropic.com/research/claude-code-expertise
- Anthropic「The AI Fluency Index」:https://academy.claude.com/tutorials/the-ai-fluency-index
- Brynjolfsson, Li, Raymond「Generative AI at Work」(NBER Working Paper 31161):https://www.nber.org/papers/w31161
- Otis ほか「The Uneven Impact of Generative AI on Entrepreneurial Performance」:https://www.hks.harvard.edu/centers/cid/publications/uneven-impact-generative-ai-entrepreneurial-performance
第三者の発信・報道(2026年10月18日確認)
- Andrej Karpathy 氏の X の投稿(2026年4月):https://x.com/karpathy/status/2042334451611693415
- Andrej Karpathy 氏の X の投稿(2026年10月):https://x.com/karpathy/status/2109361546505966046
- Ethan Mollick「Centaurs and Cyborgs on the Jagged Frontier」(コンサルタント758人の実験の紹介):https://www.oneusefulthing.org/p/centaurs-and-cyborgs-on-the-jagged
- Fortune「MIT report: 95% of generative AI pilots at companies are failing」:https://fortune.com/2025/08/18/mit-report-95-percent-generative-ai-pilots-at-companies-failing-cfo/