Claude Code のモデル名の横に「高」「中」と出ていて、何にすればいいのか迷いますよね。
私は Code タブで「高」を選んで使っています。 サブエージェント(Claude が作業を任せる別の Claude)は、既定の「中」で動いていると思っていました。
確かめると、深さを決めていないサブエージェントは、会話の「高」をそのまま引き継いでいました。 いまは、仕事の重さに合わせてサブエージェントごとに深さを分けています。
effort は、Claude が答える前にどれだけ深く考えるかの設定です。Opus 5.5 と Sonnet 5.5 は「中(medium)」から始めるのが基本です。
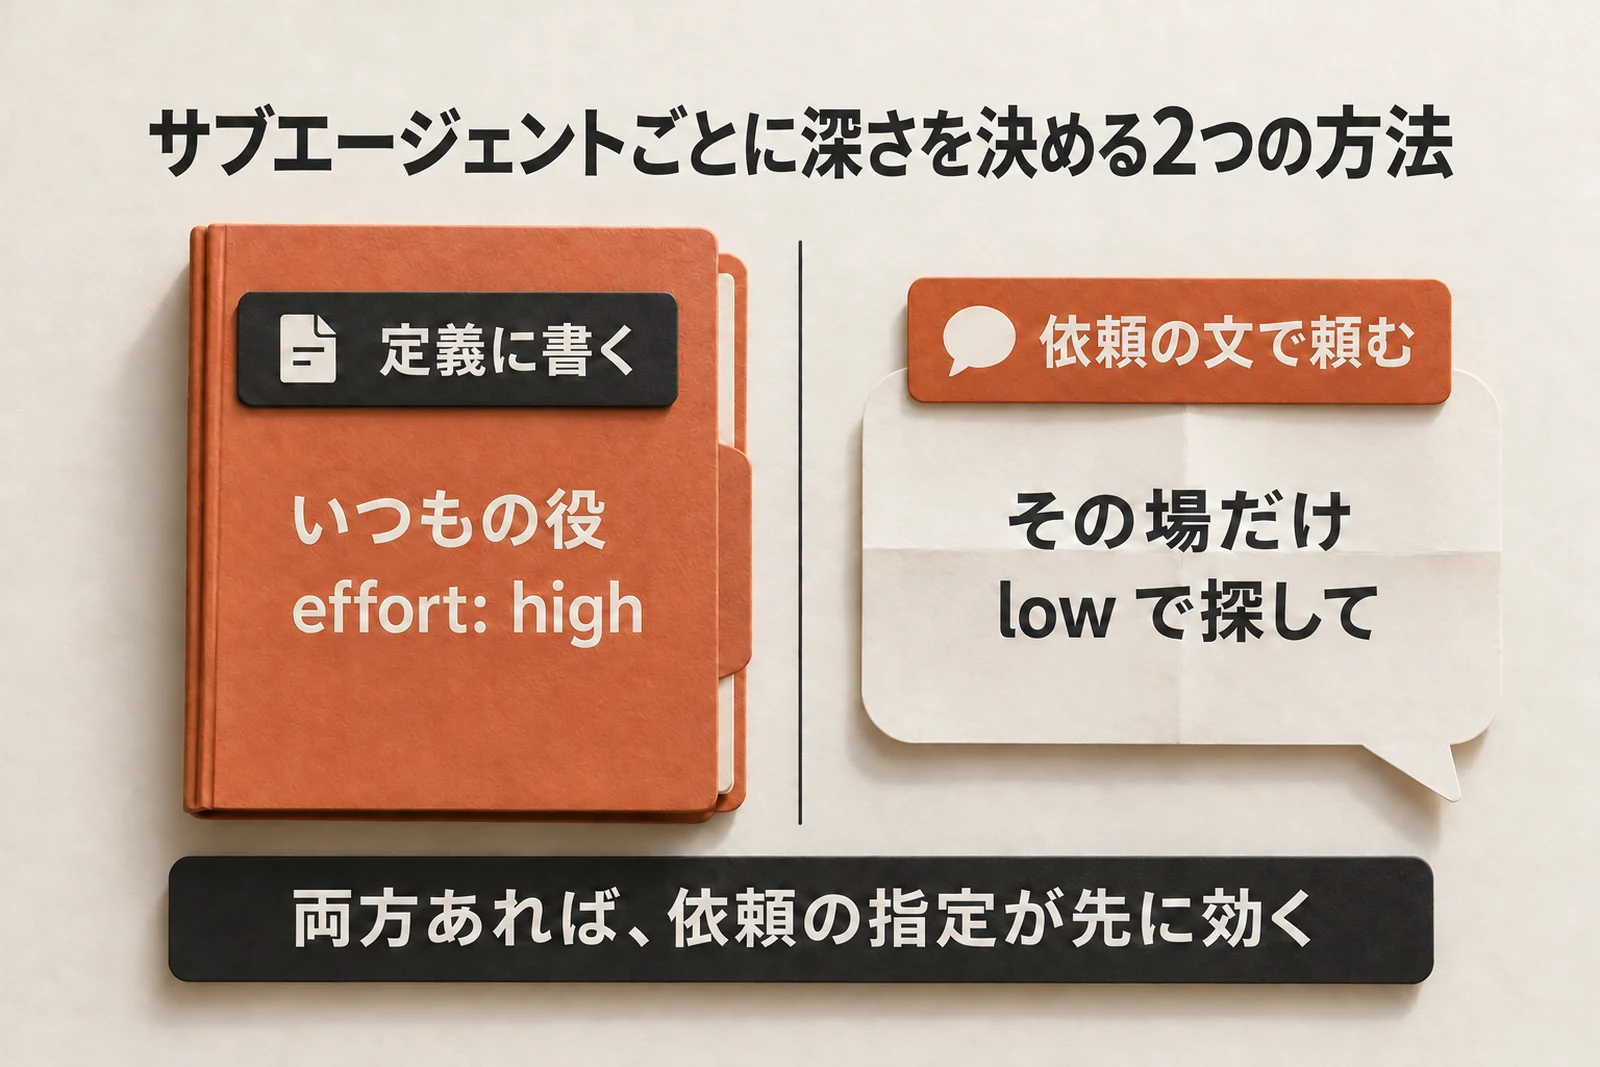
サブエージェントは、探すだけなら low、考えて判断する役は medium、独立したレビューは high と仕事で分けます。いつもの役は定義に書き、その場だけは依頼の文で頼みます。
目次
effort とは?答える前に考える深さを選ぶ設定

effort を上げれば、答えは良くなるんですか?

難しい問題なら効きます。ただ、簡単な作業だと時間と使用量が増えるだけのことが多いです。
5つの段とモデルごとの既定
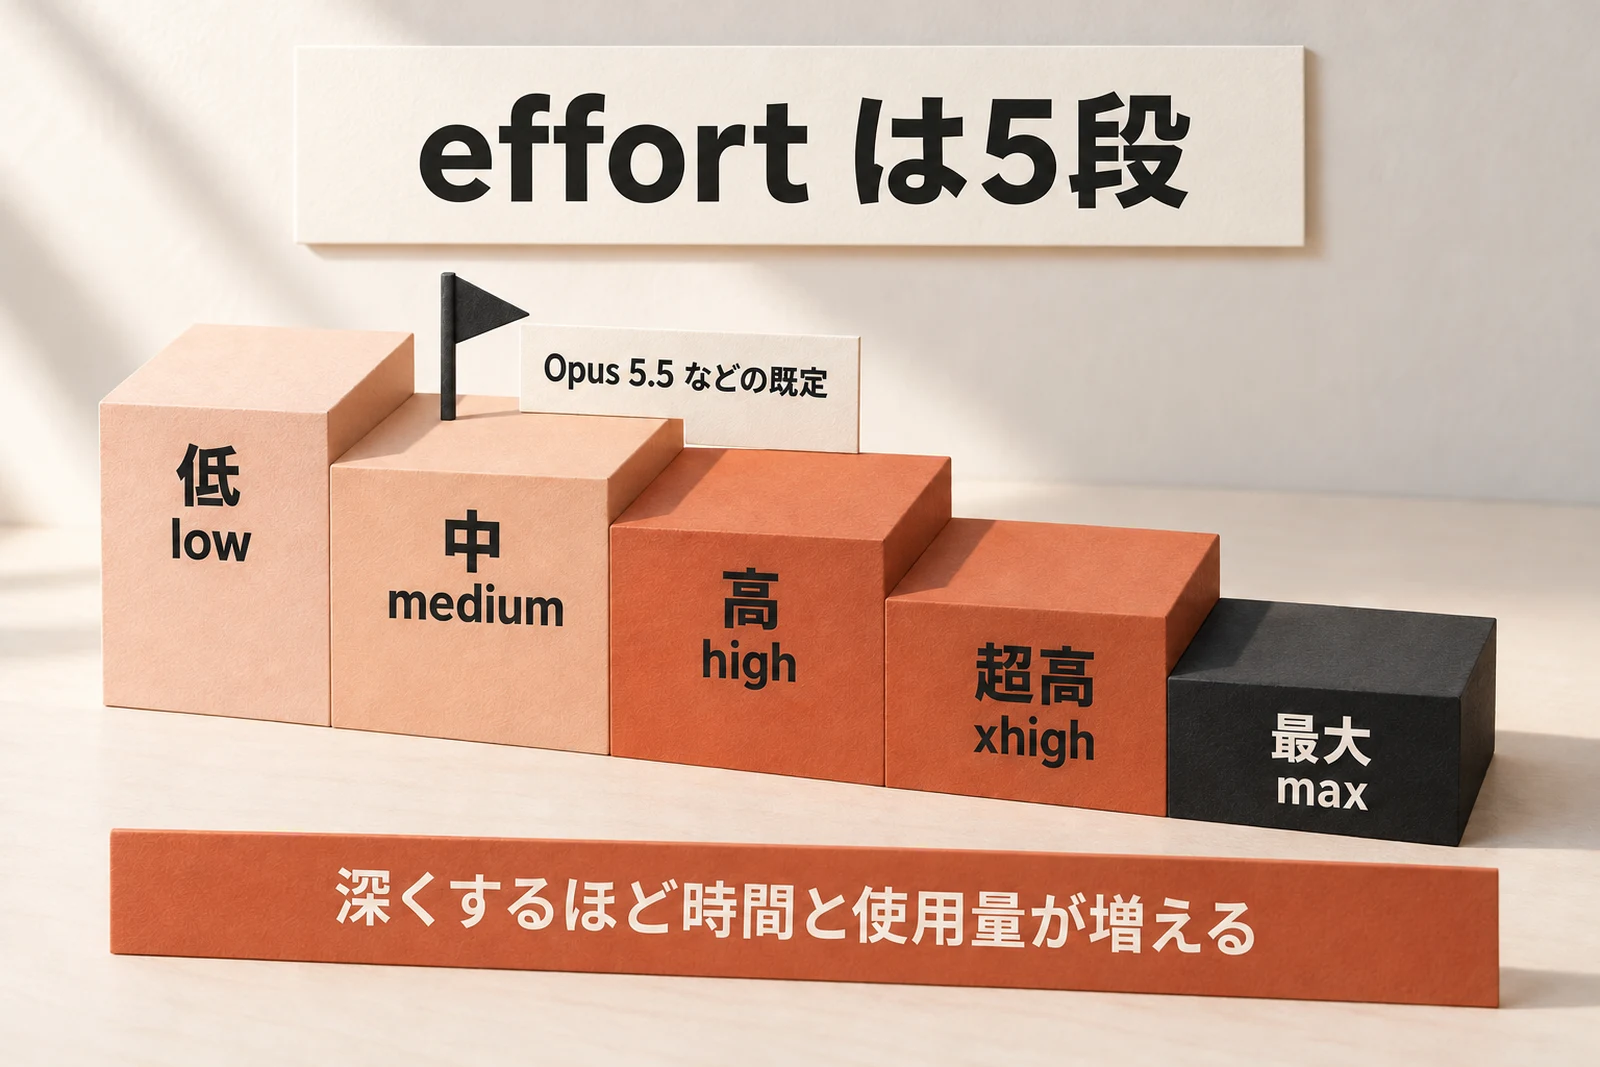
effort は、low・medium・high・xhigh・max の5段です。 アプリでは「低・中・高・超高・最大」と表示されます。
Opus 5.5・Sonnet 5.5・Haiku 5.5 の既定は medium です。 公式のモデル設定のページに、そう書かれています(2026年10月18日に確認)。
それより前のモデルは既定が high のものが多く、Opus 4.7 は xhigh です。
上げると増えるもの
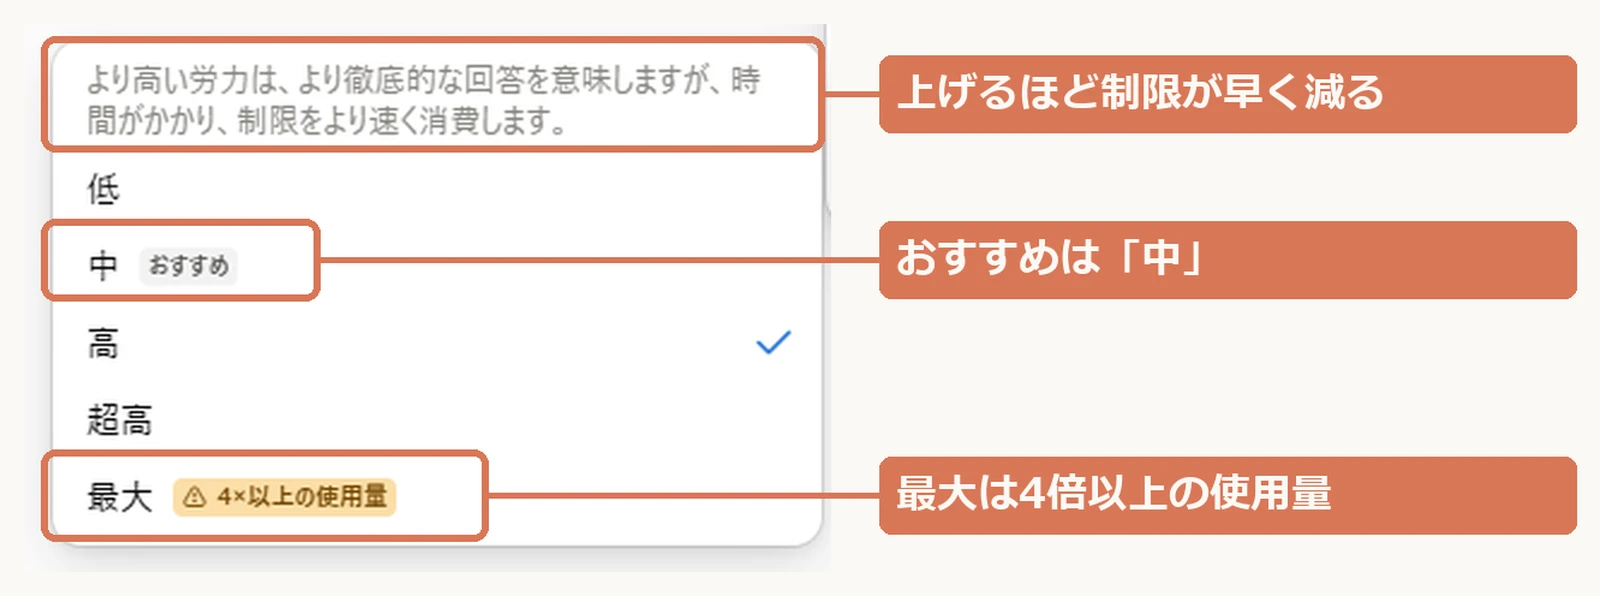
公式は、低い effort は簡単な作業で速く安く、高い effort は込み入った問題で深く考えると説明しています。
私のアプリの一覧でも、「最大」には「4×以上の使用量」と書かれています。 「中」には「おすすめ」の札が付いていました。
第三者の実測もあります。 note の「Claude Code研究所」さんは、請求明細の誤り7件を探す課題を、low から max まで1回ずつ試しました(2026年9月29日の記事)。
どの段でも7件すべて見つかり、max だけが約2分24秒かかりました(low〜high は10〜13秒)。 費用も、max は medium の2.6〜3.2倍だったそうです。
「念のため最大」にしないでください。答えが変わらないまま、時間と使用量だけが増えることがあります。足りないと感じたときだけ1段ずつ上げます。
デスクトップアプリで effort を変える方法
 Claude Opus・Sonnet・Haikuの違い|4作業で比較
Code タブで変える
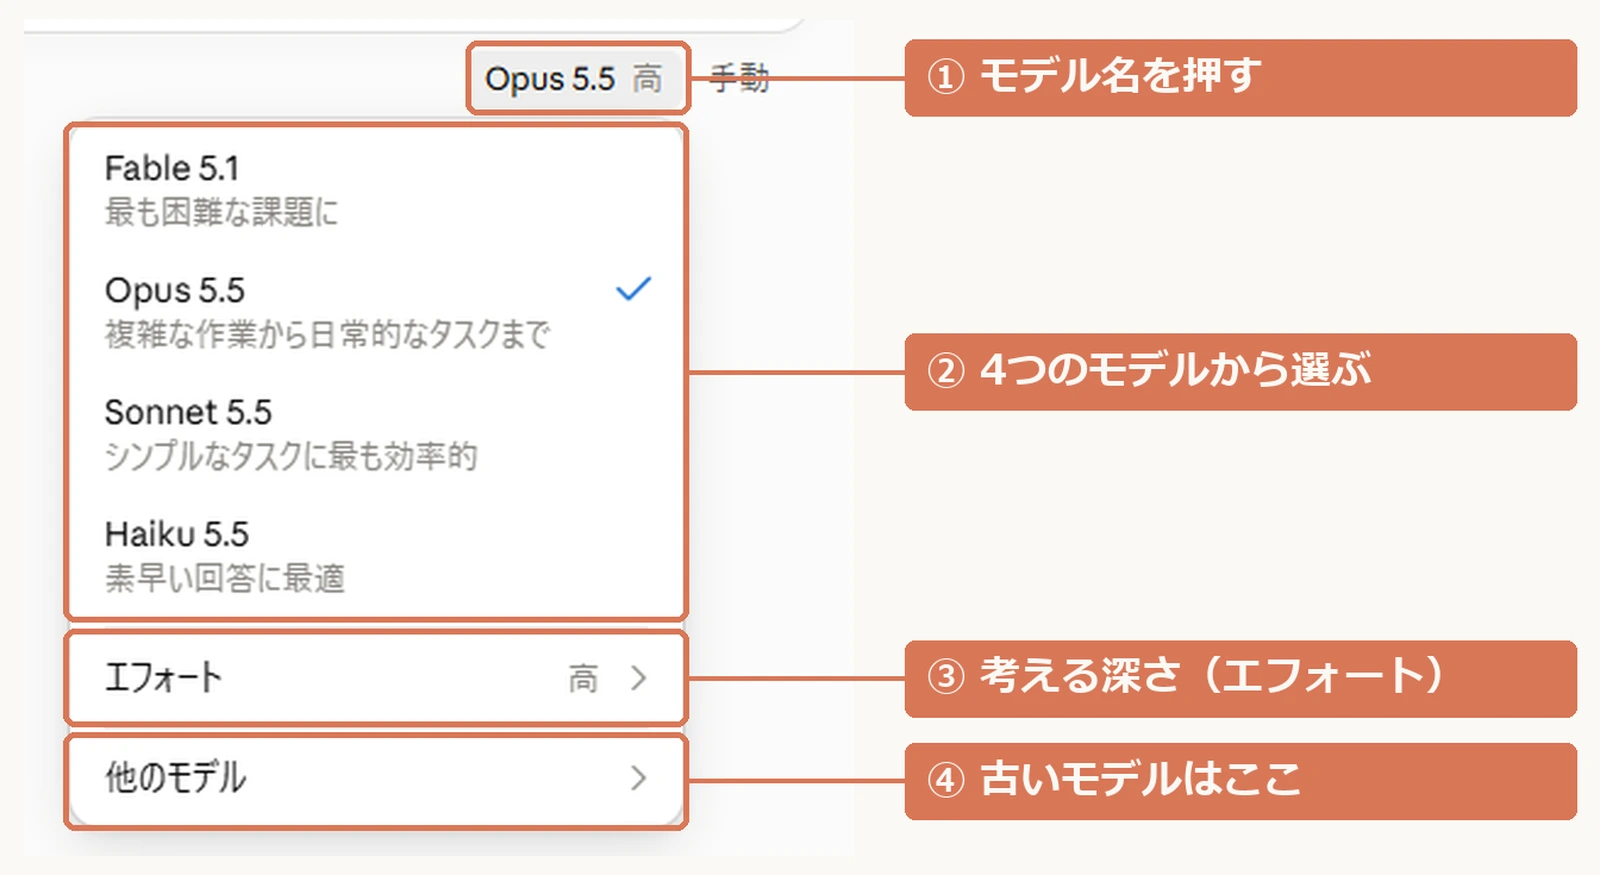
- 入力欄の下のモデル名を押す
「Opus 5.5 高」のように、モデル名と今の深さが並んでいます。
- 「エフォート」の行を開く
低・中・高・超高・最大の一覧が出ます。
- 深さを選ぶ
迷ったら、「おすすめ」の札が付いた「中」から始めます。
Code タブでは、Ctrl+Shift+E でも effort の一覧を開けます(Mac は Cmd+Shift+E)。 公式のデスクトップアプリのページのショートカットの表に載っています。
保存するか、この会話だけか
ターミナルの /effort では、選び方で残り方が変わります。
Enter で選ぶと既定として保存され、s で選ぶとその会話だけです(v2.1.257 以降)。
max は、その会話だけに効きます。 環境変数で決めた場合だけ、続けて使えます。
アプリの一覧で選んだ深さがいつまで残るかは、公式のページに書かれていませんでした。
ターミナルで使う場合
ターミナルでは、次の3つが使えます。
/effort          スライダーを開く
/effort medium   深さを直接決める
claude --effort low   起動するときにその会話だけ決める
/effort auto で、保存した深さを消して既定に戻せます。
サブエージェントごとに effort を分ける方法
 Claude Codeサブエージェントの使い方|頼み方と作り方
定義に書く(effort:)
いつも同じ役で動かすサブエージェントは、定義ファイルに書きます。
.claude/agents/ の中の、サブエージェントごとの .md ファイルの冒頭です。
私の「記事検証」の冒頭は、次のとおりです(説明の行は省きました)。
name: 記事検証
tools: Read, Glob, Grep, WebFetch, WebSearch
model: opus
effort: high
定義に書いた深さは、会話の深さより優先されます。 会話を「中」で使っていても、このサブエージェントだけは high で動きます。
依頼文で頼む(コピーできる例)
その場だけ深さを変えたいときは、依頼の文に書くだけです。 v2.1.292 から、Claude がサブエージェントを起動するときに深さを渡せるようになりました。
関連するファイルの洗い出しは、low effort のサブエージェントに任せてください。
見つかった箇所の扱いを決めるのは、high effort のサブエージェント1体にしてください。
どちらもファイルは変えず、根拠のファイル名と行番号を返してください。
公式の週刊メールの例も、同じ形でした。 探すだけのサブエージェントは low、見つかったものを考える1体は high です。
どれが先に効くか
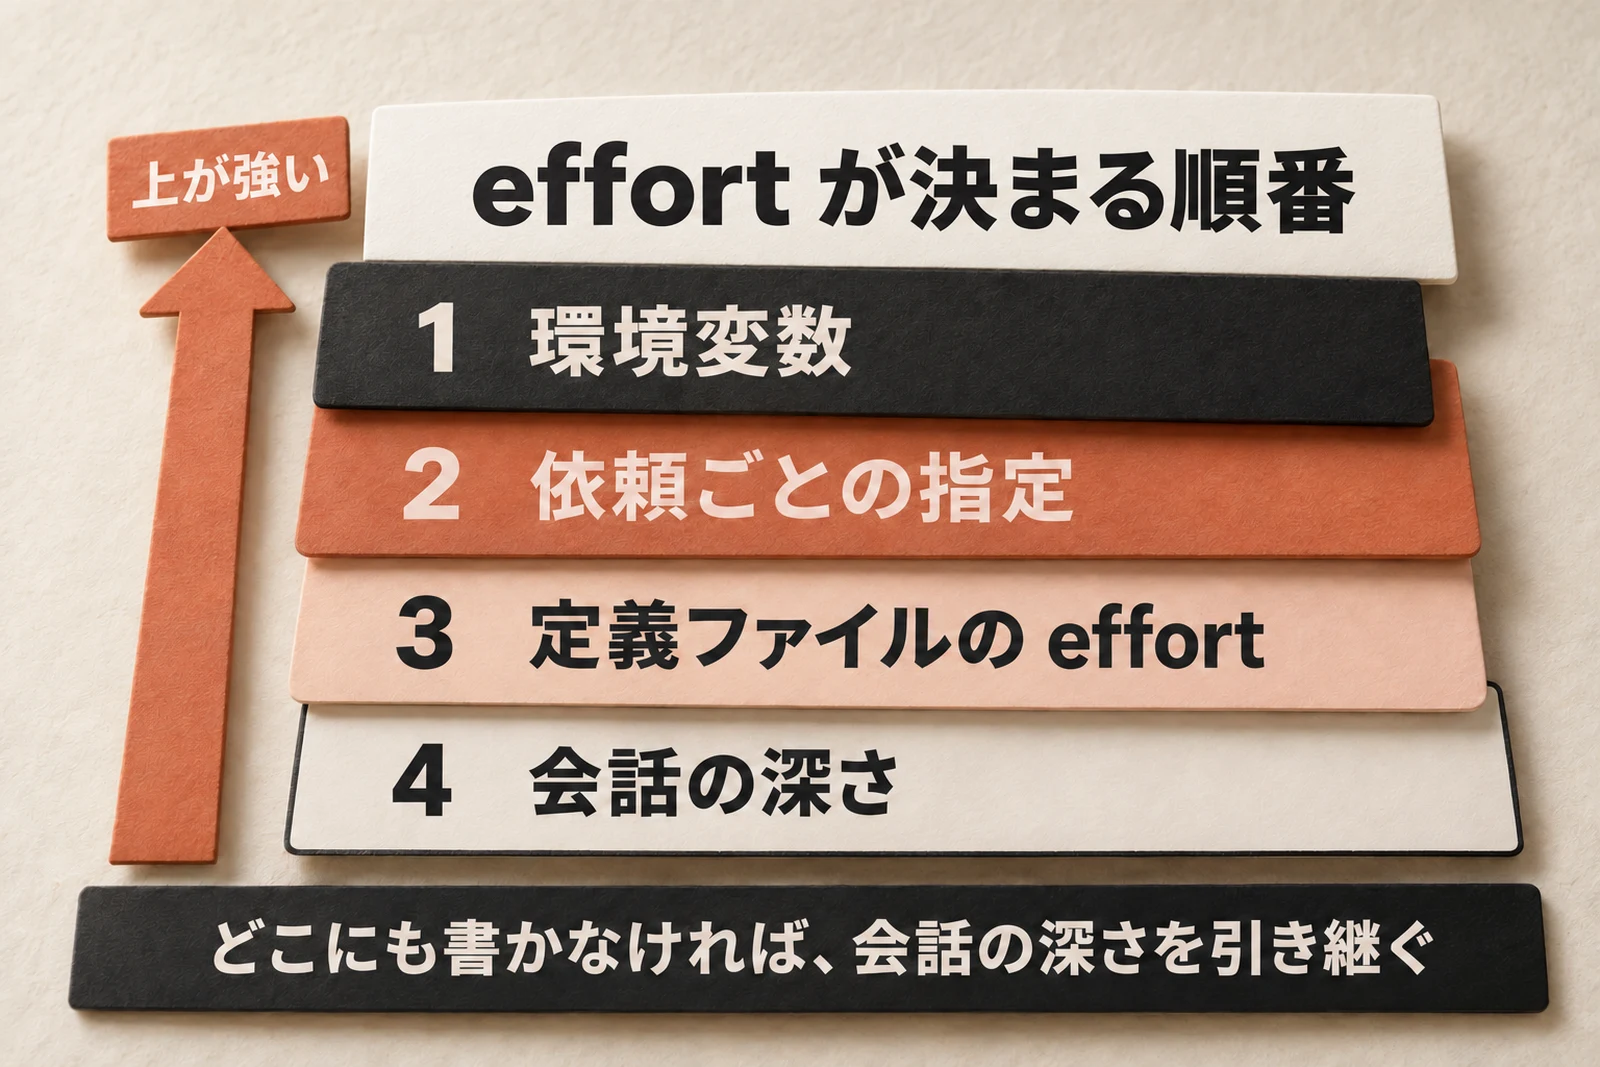
深さを決める場所は4つあり、上が強い順です。
- 環境変数
CLAUDE_CODE_EFFORT_LEVEL - 依頼ごとの指定(v2.1.292 以降)
- 定義ファイルの
effort: - 会話の深さ
どれにも書いていないサブエージェントは、会話の深さをそのまま引き継ぎます。 ここが、私がつまずいたところでした。
私は7体をこう分けた
Claude Code に、自作のサブエージェントが7体あります。2026年10月18日に、7体の定義すべてに effort を書きました。
7体の表と理由
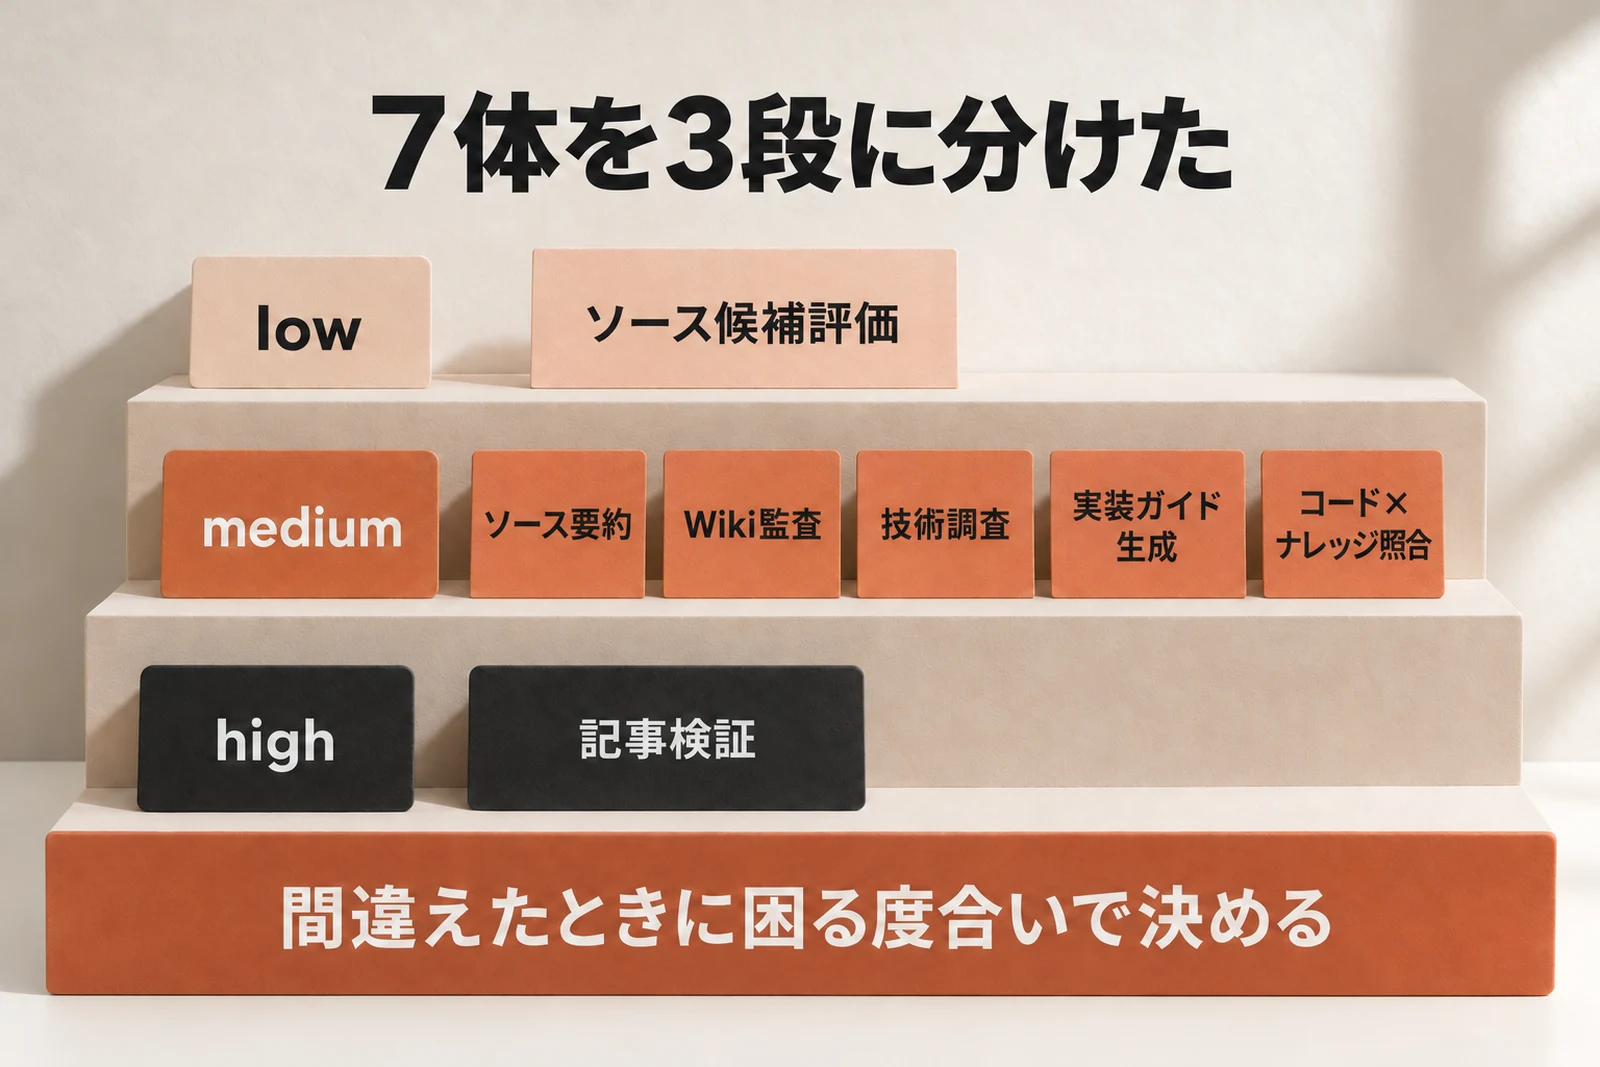
| サブエージェント | 仕事 | effort |
|---|---|---|
| ソース候補評価 | 集めた URL を読んで、取り込む優先度を付ける | low |
| ソース要約 | 長い資料を読んで要約する | medium |
| Wiki監査 | 自分の wiki 全体を点検する | medium |
| 技術調査 | Web で最新の情報を調べる | medium |
| 実装ガイド生成 | wiki をもとに手順書を作る | medium |
| コード×ナレッジ照合 | コードと wiki を突き合わせる | medium |
| 記事検証 | 記事を、書いた側とは別に確かめる | high |
分け方の考え方は1つです。 間違えたときに困る度合いで決めました。
「記事検証」は、見落とすと誤った記事が出ます。だから high です。 「ソース候補評価」は、取り込むかどうかを最後に私が選びます。だから low にしました。
定義の冒頭は、次の1行を足しただけです。
effort: low
探す役には「時間が大事」の1文を足した
2026年10月17日の公式の週刊メールに、Anthropic のエンジニアのコツが載っていました。 サブエージェントは「速さより徹底」に寄りがちで、次の1文を足すとペースが変わる、という話です。
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better.
意味は「ここでは時間が大事。避けられる時間は使わず、正しい結果が早いほど良い」です。
私は、探して振り分けるだけの「ソース候補評価」にだけこの1文を足しました。 「記事検証」や「ソース要約」は急がせたくないので、入れていません。
この1文は公式ドキュメントには無く、メールの社員のコツです。 私のサブエージェントで効果を測ったわけではありません。
low と high で同じ調べ物を比べた
条件
同じ種類のサブエージェント(モデルは Opus)に、同じ依頼の文を2回頼みました。 違いは effort だけで、1回は low、もう1回は high です。
頼んだのは、自分の wiki にある Claude のモデルのページから「effort の既定値」を探して、表にする調べ物です。 ファイルは変えず、根拠の行番号も返させました。
結果
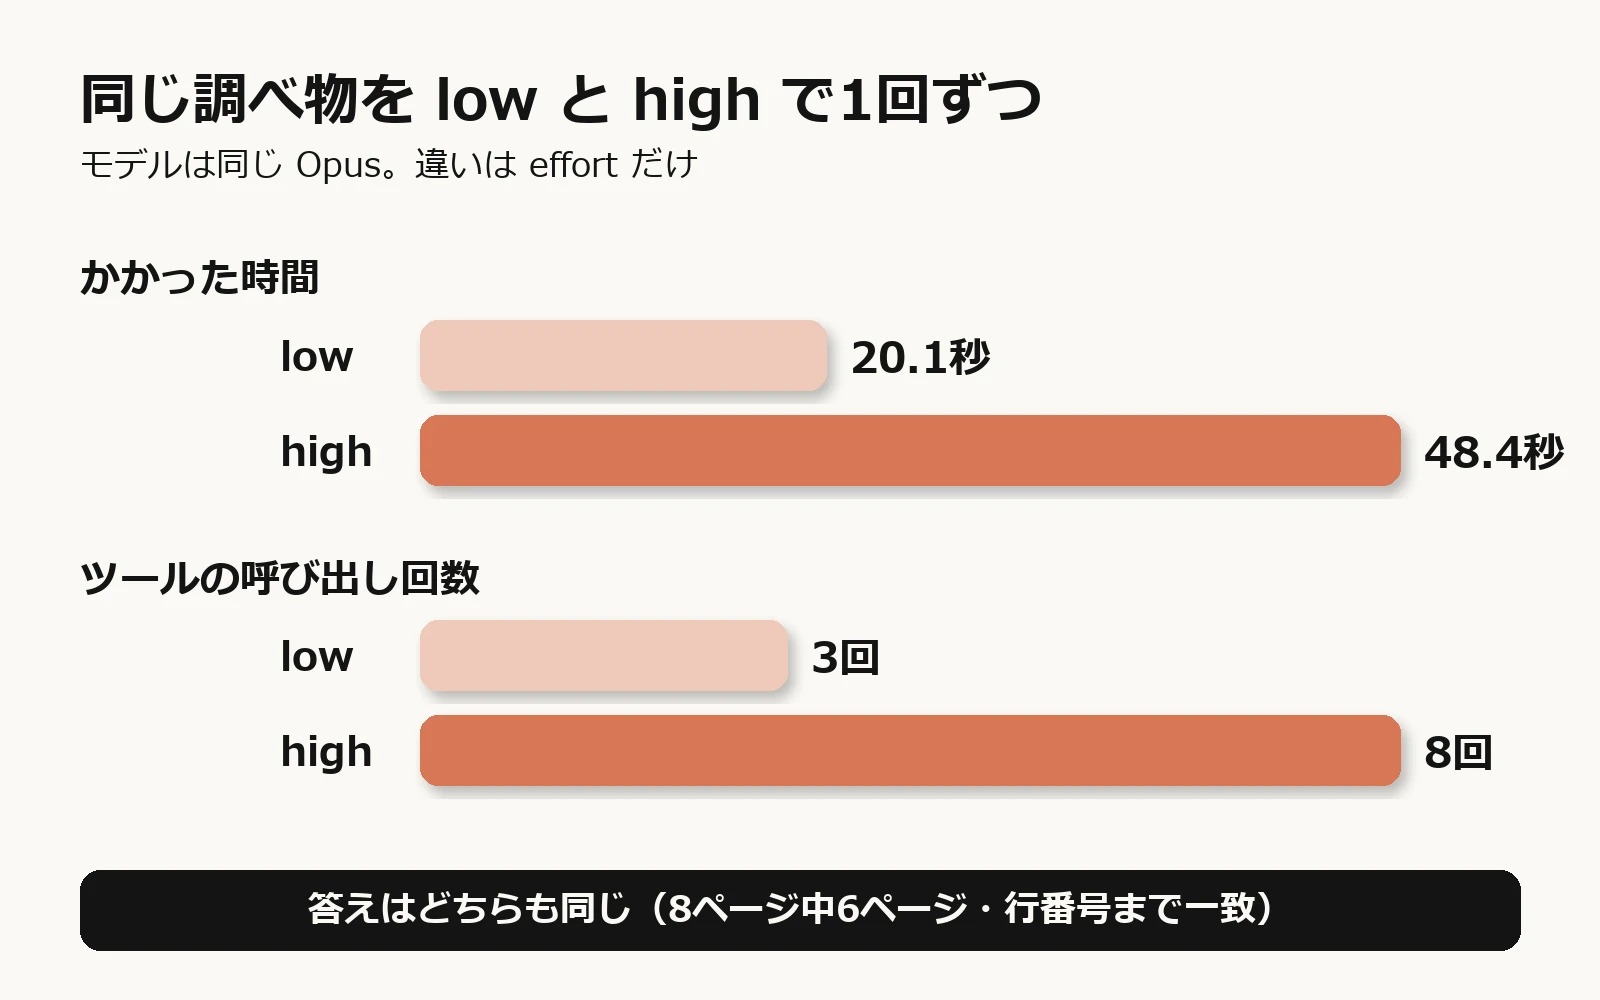
| low | high | |
|---|---|---|
| かかった時間 | 20.1秒 | 48.4秒 |
| ツールの呼び出し回数(Read・Grep など) | 3回 | 8回 |
| 使ったトークン | 89,735 | 98,968 |
| 答え | 8ページ中6ページ(正しい) | 同じ |
赤い数字は、その行でいちばん少ない値です。
答えの正しさは、この調べ物では同じでした。 high は約2.4倍の時間をかけて、同じ表を返しました。
分かったこと
high は、ページの中の細かい違いを1つ多く見つけていました。 一方で low も、別の気づきを1つ書いていました。
答えの形が決まっている調べ物なら、low で足りました。 ただし1回ずつの比較です。「いつでも low で十分」とまでは言えません。
トークンの差が約1割と小さいのは、どちらのサブエージェントも最初に同じ決まりの文書を読み込むためだと考えています。
設定が効いているかを確かめる
設定ファイルの high が効かなかった
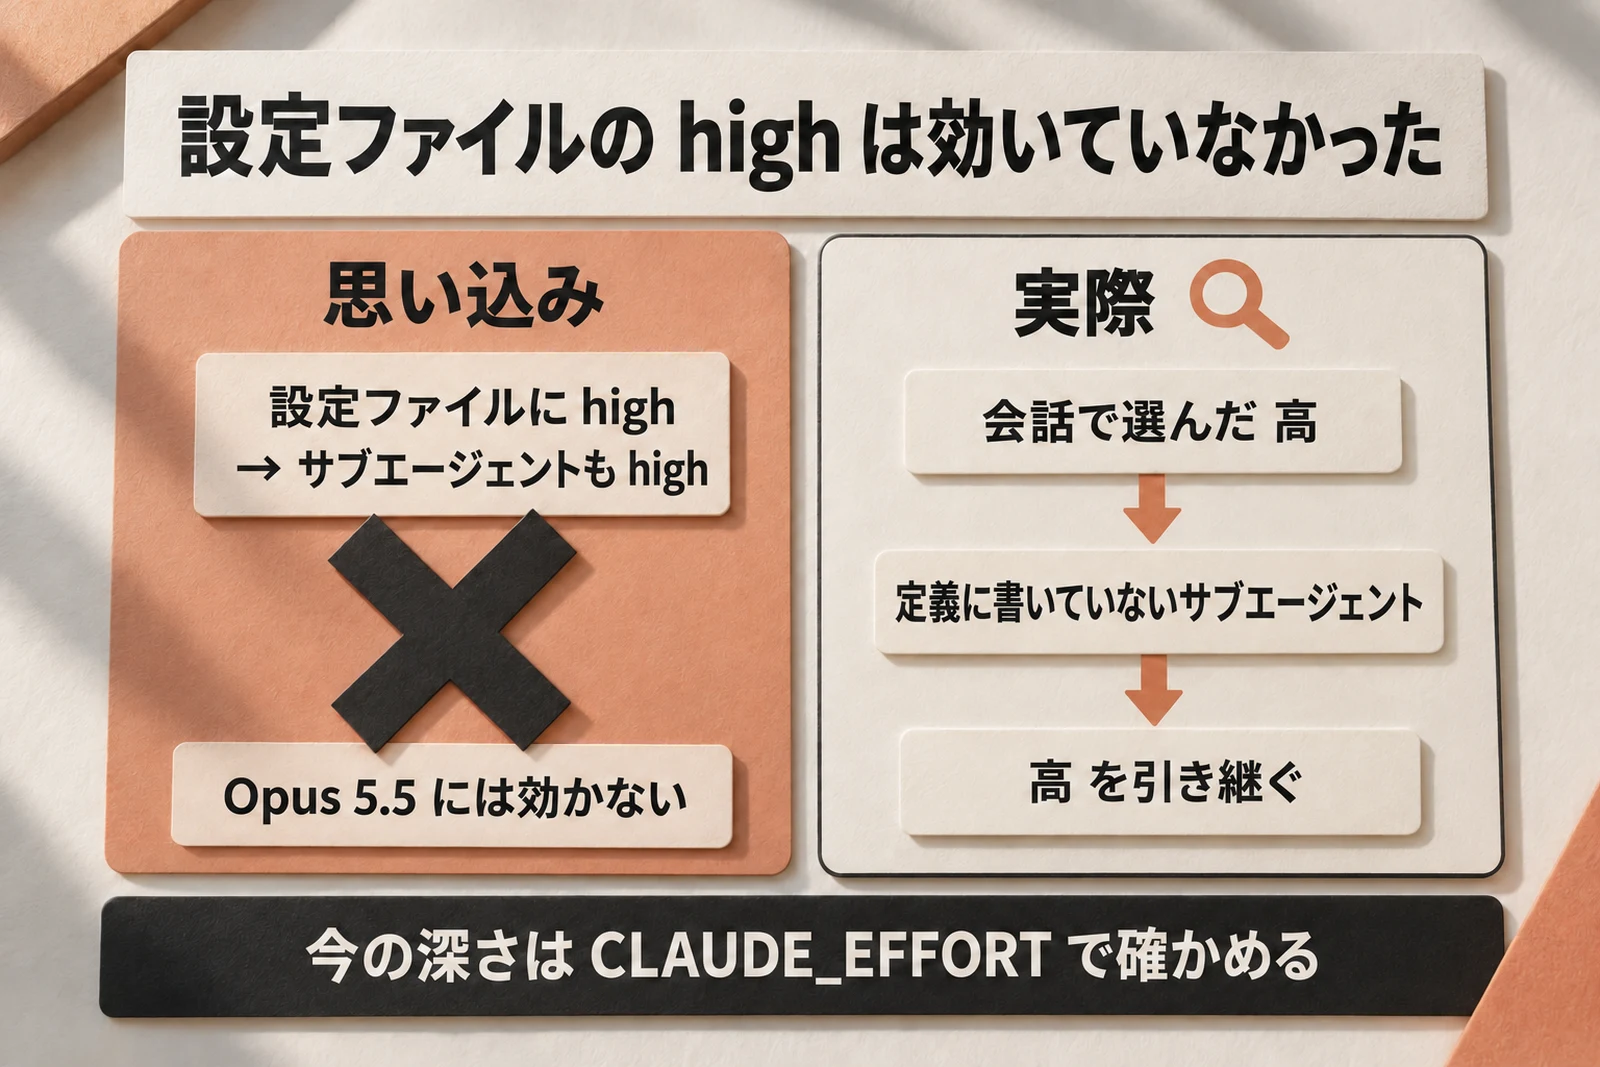
私の設定ファイル(~/.claude/settings.json)には、次の1行があります。
"effortLevel": "high",
ところが公式のページによると、設定ファイルの一番上の effortLevel は、Opus 5.5 には効きません。
モデルごとに深さを保存するようになる前の、古い書き方だからです。
さらに、私の決まりには「定義に書かなければ既定の medium で動く」と書いていました。 これも違いました。
定義に書いていないサブエージェントは、会話の深さを引き継ぎます。 私は Code タブで Opus 5.5 を「高」で使っているので、定義に書く前は、探すだけのサブエージェントも「高」を引き継いでいたことになります(回ごとの記録は残っていません)。
/tasks で見る
ターミナルでは、/tasks を開くと、サブエージェントごとのモデルと、決めた effort が表示されます(v2.1.242 以降)。
もっと確実なのは、いま効いている深さを Claude に表示させる方法です。
公式には、Bash の中に今の effort が入る変数 CLAUDE_EFFORT があります。
Code タブで、次のように頼むだけです。
Bash で echo $CLAUDE_EFFORT を実行して、出力をそのまま見せてください。
私の会話では CLAUDE_EFFORT=high と出ました。
深さを指定しないサブエージェントに同じことをさせると CLAUDE_EFFORT=high、low を指定したサブエージェントは CLAUDE_EFFORT=low でした。
「書いたから効いている」と思い込まず、一度は今の深さを表示させて確かめるのが近道です。
環境変数は全部より強い
環境変数 CLAUDE_CODE_EFFORT_LEVEL を決めると、定義も依頼ごとの指定も効かなくなります。
サブエージェントごとに分けたいなら、この環境変数は使いません。 私も使っていません。
よくある質問
high にすれば精度は上がりますか?
難しい判断には効きますが、答えの形が決まった作業では変わらないことが多いです。 私の実測でも、第三者の実測でも、同じ答えのまま時間だけが増えました。
max は使うべきですか?
普段は使いません。 max はその会話だけに効き、使用量が大きく増えます。どうしても足りないときに、その会話だけで試します。
Codex でもできますか?
できます。Codex は .codex/agents/ の定義ファイルの model_reasoning_effort で決めます。
依頼の文で頼むこともできます。
違いが1つあります。 Codex は定義ファイルの値が優先され、Claude Code は依頼ごとの指定が優先されます(どちらも公式のページで確認)。
古い版では使えませんか?
定義ファイルの effort: は、それより前の版から使えます。
依頼ごとに深さを渡すのは v2.1.292 以降です。
私のパソコンのターミナルの claude は 2.1.285 でした(2026年10月18日)。
ターミナルの夜間の自動処理で深さを分けたいときは、定義ファイルに書いておくのが確実です。
まとめ
- effort は「答える前にどれだけ深く考えるか」の設定。Opus 5.5・Sonnet 5.5 は medium から始める
- サブエージェントは仕事で分ける。探すだけ low・考える役 medium・独立したレビュー high
- いつもの役は定義ファイルに書き、その場だけは依頼の文で頼む
- 定義に書かないサブエージェントは、会話の深さを引き継ぐ。設定ファイルの一番上の
effortLevelは Opus 5.5 に効かない - 効いているかは、
CLAUDE_EFFORTを表示させて一度確かめる
参考資料・出典
公式(2026年10月18日に確認)
- Claude Code Docs「Model configuration」(Adjust effort level):https://code.claude.com/docs/en/model-config
- Claude Code Docs「Create custom subagents」(Choose an effort level):https://code.claude.com/docs/en/sub-agents
- Claude Code Docs「Use Claude Code Desktop」(キーボードショートカット):https://code.claude.com/docs/en/desktop
- Claude Code Docs「Environment variables」(CLAUDE_EFFORT):https://code.claude.com/docs/en/env-vars
- Claude Code リリース v2.1.292(GitHub):https://github.com/anthropics/claude-code/releases/tag/v2.1.292
- OpenAI Codex「Subagents」:https://developers.openai.com/codex/subagents
- Claude 公式の週刊メール「This week in Claude Code」(2026年10月17日受信・公開ページなし)
第三者の検証・発信(2026年10月18日に確認)
- Claude Code研究所「Claude Codeのeffortはmediumのまま。実測8回と在籍者の発言」(note・2026年9月29日):https://note.com/claudecode_lab/n/nb15b49661836
- とあるITエンジニア「grepまで深く考えさせるな。Claude Code 2.1.292のeffort指定」(X・2026年10月10日):https://x.com/hyu001225/article/2108845761991762323
- Wmedia「Claude Code effort: not the level you think you have」(2026年7月29日):https://wmedia.es/en/tips/claude-code-effort-not-the-level-you-think